本文述说了在SceneQuery场景下的加速结构BVH。
本文是SceneQuery的最后一篇文章。至此,所有的SceneQuery技术都已叙述完毕。
当然还有其他空间划分方法(SAP,OctTree,K-DTree等)。但这些一般用于模拟时的空间划分,等到模拟章节再说。
绝大部分理论来自于Erin Catto的GDC分享1(建议阅读)和PBRT2,而实现则参考PhysX5.4.0。
BVH构建更多的理论来源于渲染中光线追踪方向。其中有很多乱七八糟的BVH构建(在CPU上,或使用并行计算,或在GPU上构建)。本文不说那么多乱七八糟的,只说常用的方法。
BVH#
Bounding Volume Hierarchy。即带有层次的BV。
因为和BV的SceneQuery非常快,所以我们可以:
- Raycast:先尝试使用射线和BV判交,如果成功,再对里面的物体做真正的Raycast
- Sweep:先尝试用Sweep扫略过的路径构成的AABB和BV判交,成功再对里面物体做Sweep
- Overlap:尝试先和BV判交,成功再对里面物体做Overlap
但按这个算法,每次做Query还是得对所有物体的BV做一次判交。而BVH则是通过将BV以树状方式组织,以减少大部分物体的BV判交。
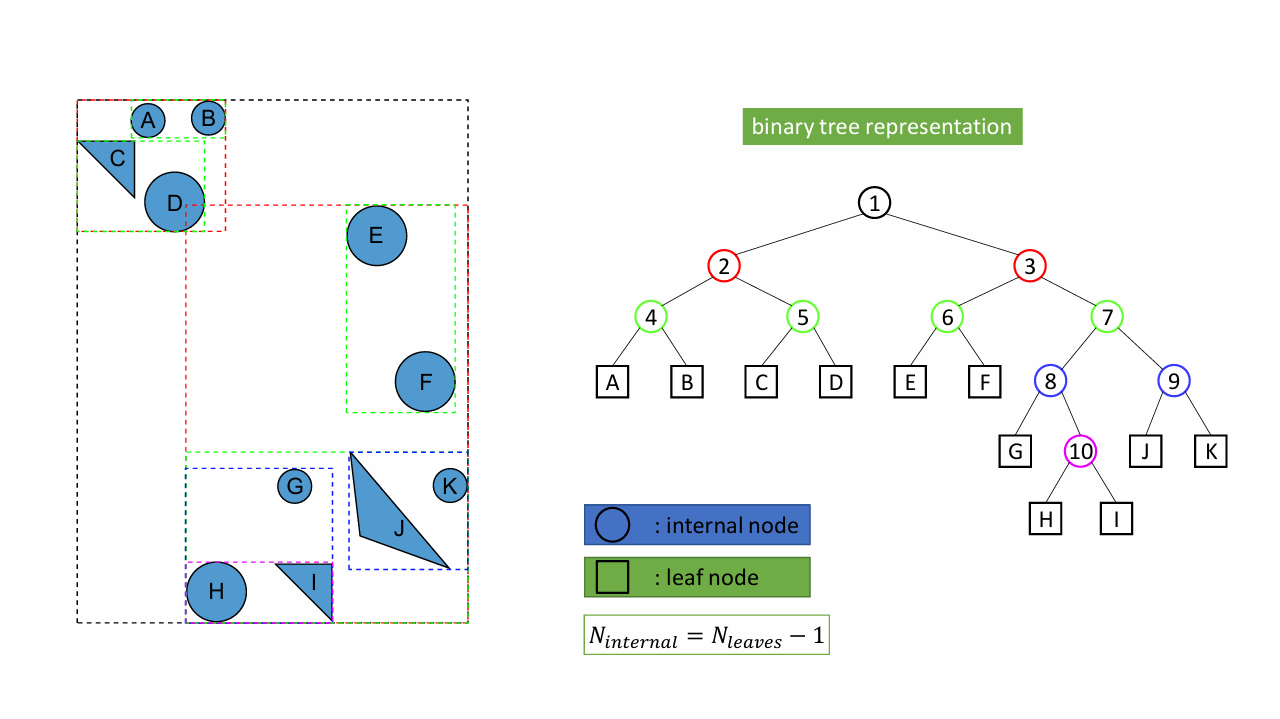
这里每个节点都有自己的BV(这里是矩形),父节点的BV包含子节点的BV,以Raycast为例,每次进行计算时,先用光线和根节点的BV判交,如果成功,就进入到子节点,和两个子节点BV判交(节点2和3),以此类推。这样,如果和某个节点的BV不相交,那么就不需要测试其下的所有BV了。这样可以大大过滤很多判交。
这种通过预先使用快速手段过滤大部分物体的方式叫做BroadPhase(宽检测/宽阶段)。而过滤后真正和物体本身的几何(非BV)做真的Query算法则叫做NarrowPhase(窄检测)。BroadPhase的目标就是尽可能减少进入NarrowPhase的物体。
BVH构建#
BVH的理论很简单。难的是如何构建。
首先是BV的merge算法,指如何将两个BV合二为一。对于AABB来说就是:
AABB Merge(AABB a, AABB b) {
	AABB c;
	c.min = Min(a.min, b.min);
	c.max = Min(a.max, b.max);
	return c;
}
而对于BVH构建,一般而言是构建成一颗二叉树(其实可以任意叉树,但从工业实践经验来说二叉最好),目前业界至少有三种构建方法:
构建算法:
- TopDown(自顶向下): 根节点包含所有物体。然后对于当前节点,将物体列表一分为二,所有在左边构成子节点1,所有在右边的构成子节点2。然后左右节点算各自包含物体的BV的merge(合成大BV)。然后对两个子节点递归地做同样的事情,直到子节点内物体数量降低到阈值(此阈值是用户给的,PhysX是15)。
- BottomUp(自底向上):和自顶向下反过来
- Incremental(增量式):不停地向树中插入新物体来构建。新物体通过遍历树的节点来判断自己的BV被哪个节点完全容纳。
Catto的GDC分享1中有展示一步步构建的过程,这里不再赘述。
其中TopDown和BottomUp方式在增加/删除新节点时只能重建树,所以一般用来容纳静态物。而 Inremental方式则用于容纳动态物。
一般的做法是,找到当前节点所包含的BV最长的那个轴,然后在这个轴上使用垂直于此轴的平面划分空间,得到此节点的两个子节点。而如何选定此轴,有两种策略。
中位数法#
以此轴上物体BV的中心点$c_i$排序,找到中心点中位数$c_{median}$所在的物体A。所有中心点小于$c_{median}$的物体全部分到子节点1中,大于等于的放到子节点2中。 缺点是: 1. 可能会导致某子树上物体过多,而另一个树上物体太少。这可能导致射线总是打中物体多的节点,从而导致BVH作用降低。 2. 节点BV之间存在互相重叠的情况。重叠越多,射线同时穿过两个区域的概率就越大,BVH的作用越低。
我测试了包含一万个静态物的BVH重建(单线程),平均耗时到2.4ms。测试链接会放在本文最后,可以试一下(不过网页版肯定性能更差)。而下文要介绍的SAH平均耗时在2.6ms(好像相差并不是很大,也不知道是不是我代码写的问题)。但中位数法创造了2047个节点,SAH法只创造了1933个节点: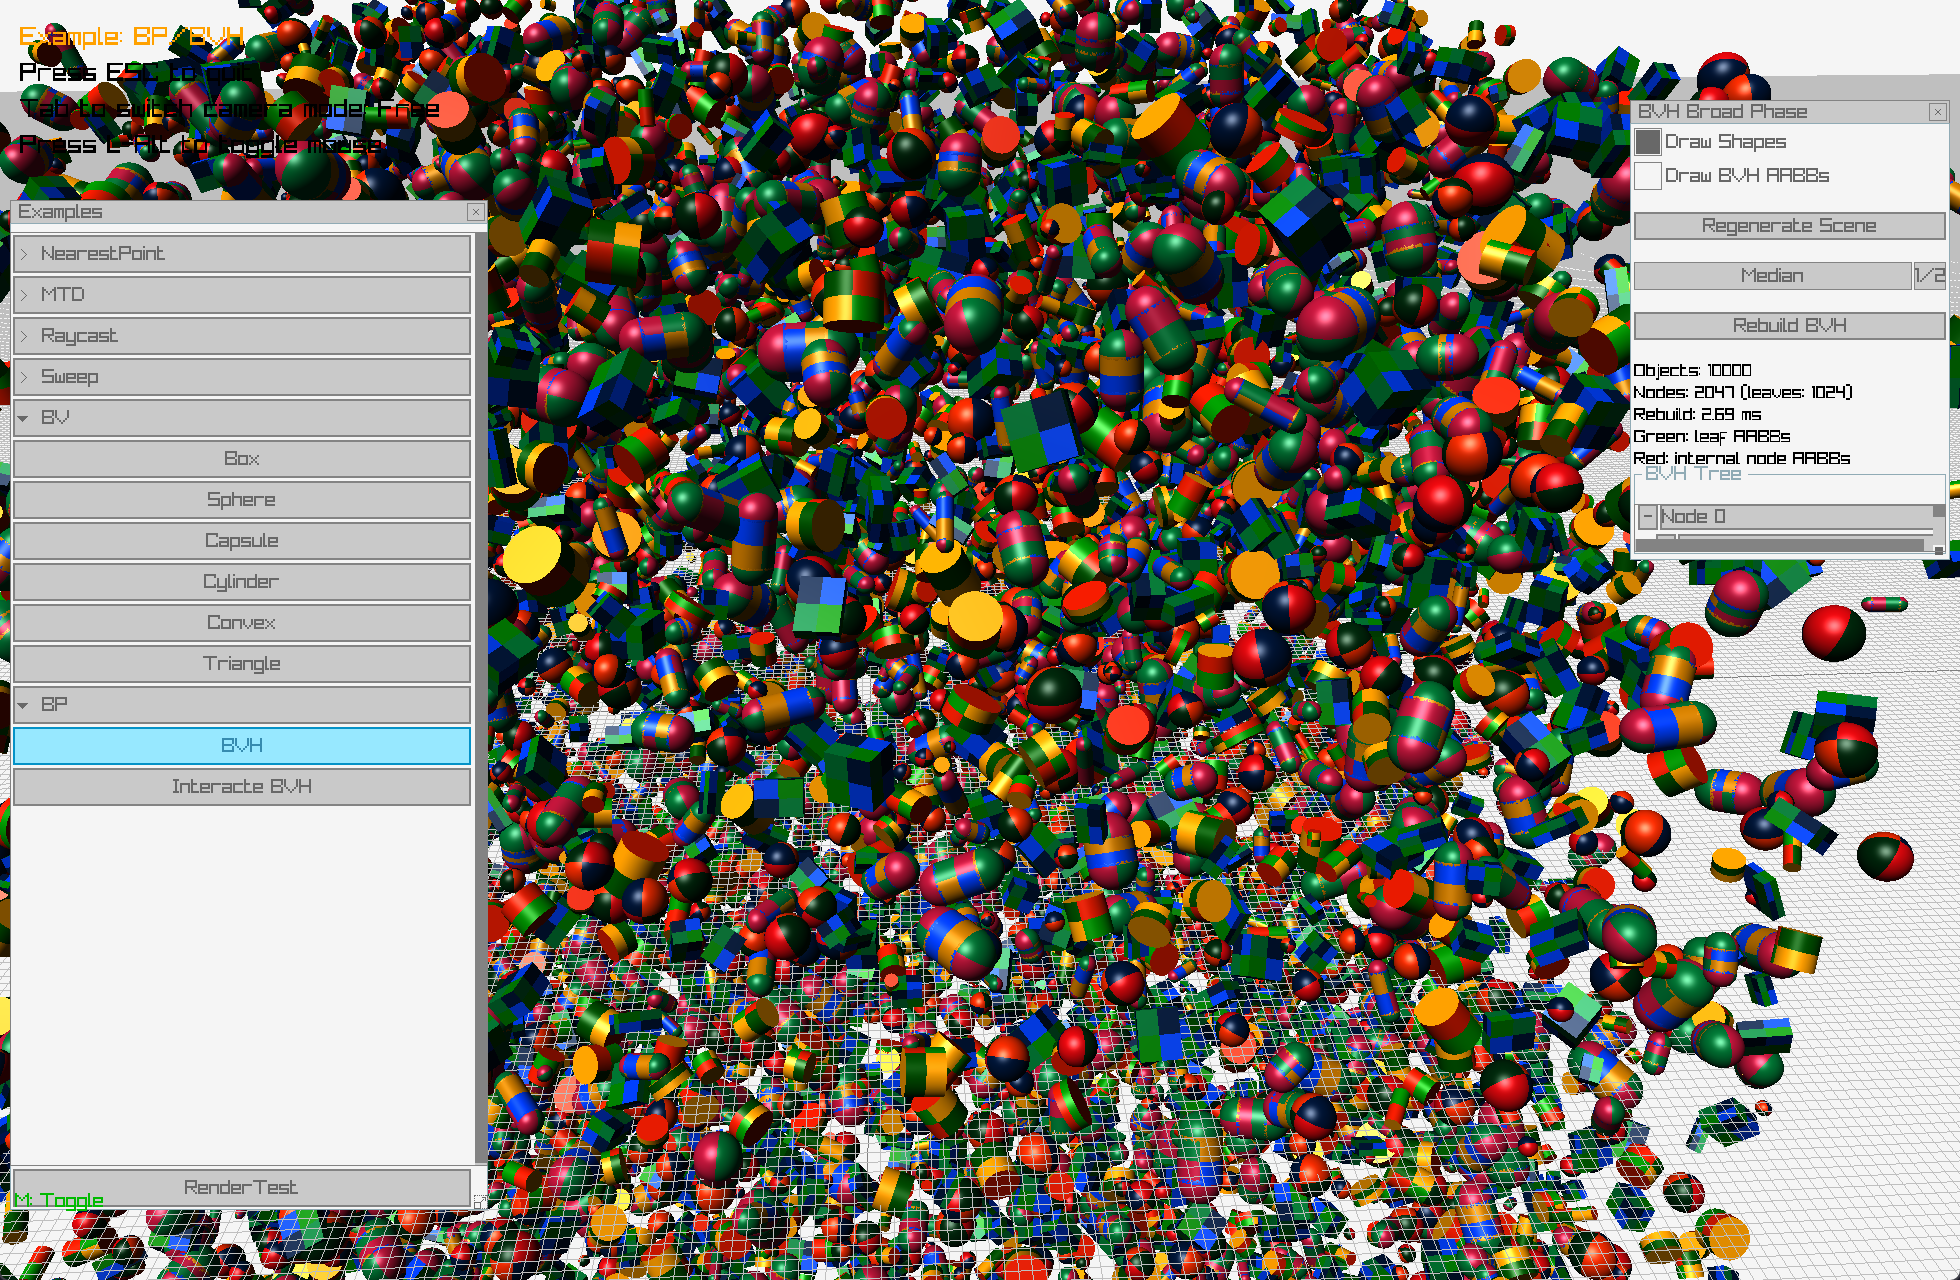
我的CPU配置:
Binned SAH#
SAH(Surface Area Heuristic,面积启发式算法)2:基于一个事实:射线击中物体的概率取决于物体的面积比例。而SAH就是算所有BV的面积,对于AABB来说就是:
float ComputeCost(Tree tree) {
	float cost = 0.0f;
	for (int i = 0; i < tree.nodeCount; i++) {
		cost += Area(tree.nodes[i].nbox)
	}
}

float Area(AABB aabb) {
	Vector3 d = aabb.max - aabb.min;
	return (d.x * d.y + d.x * d.z + d.y * d.z) * 2;
}
就只是计算AABB的表面积(当然这个面积可以预计算存在AABB中)。
对于与任意节点的BV相交的射线来说,要对节点中每个物体做Query。将这个代价记为:
$$ \sum_{i = 1}^n t_{isect}(i) $$其中$n$是节点中元素个数。$t_{isect}$则是此光线和第$i$个元素Query的代价。
那么假设此节点还能够细分成$A$, $B$两个节点,那么现在的代价就是:
$$ c(A, B) = t_{trav} + p_A \sum_{i = 1}^{n_A} t_{isect}(a_i) + p_B \sum_{i = 1}^{n_B} t_{isect}(b_i) $$其中$t_{trave}$是射线经过上层节点的耗时(或者说确定和此节点Query的耗时),$p_A$则是此射线和节点$A$要做Query的概率。后面的求和则是和对应子节点的Query耗时。
我们假设$t_{isect}(i)$对任意物体来说都一样(你可以认为是射线和物体BV做Query,这样他们的代价就一样了。至于NarrowPhase的代价不算入内)。
那么对于作为$C$节点的子节点$A$,我们可以算经过$C$节点时经过$A$节点的概率,用条件概率:
$$ p(A|C) = \frac{S_A}{S_C} $$就变成两者面积的比值(你问我为什么是面积比我也不知道,这好像是一个数学定理)。
那么我就可以直接用$p(A|C)$的值作为$p(A)$的值带入到$c(A, B)$了。
那么由于我们假设了$t_{isect}$代价一样,那么就有:
$$ c(A, B) = t_{trav} + \frac{S_A}{S_C} \cdot Q\cdot n_A + \frac{S_B}{S_C} \cdot Q\cdot n_B $$这里$Q$是一个常数。
那么我们要找的就是满足$c(A, B)$最小的$C$空间的切分法:
首先在算法最开始的最长的那个轴上,将轴均匀等分(每个等分区间称为桶(bucket)),至于分多少那是手动配置的。PBRT是12。
然后对于桶和桶之间的每条缝,找到此缝左右两边所有桶的代价。
这里通过$c(A, B)$的公式可以知道,对于任意缝,$Q$和$S_C$都是固定的,而且$t_{trav}$和缝的选择也无关,所以我们只需要计算
$$ S_A \cdot n_A $$就行。那么将缝左边视为$A$区域,右边视为$B$区域,我们可以得到简化版的$c(A, B)$:
$$ c(A, B) = S_A \cdot n_A + S_B \cdot n_B $$即为:将缝左/右边所有图元的BV并起来,然后算此BV的表面积(SAH值)乘上缝左/右边的图元个数。最后这条缝的代价$c$就是左代价+右代价。
最后取代价最小的那条缝作为分割缝。
所以这里也就看出,缝越多(桶越多),这个代价计算越精细。但Wald在他的论文3中说在16~32个桶之间最好,超出会导致收益饱和。
而如何判断物体BV到底在缝左边还是右边,只需要看BV的中心点在左边还是右边就行:
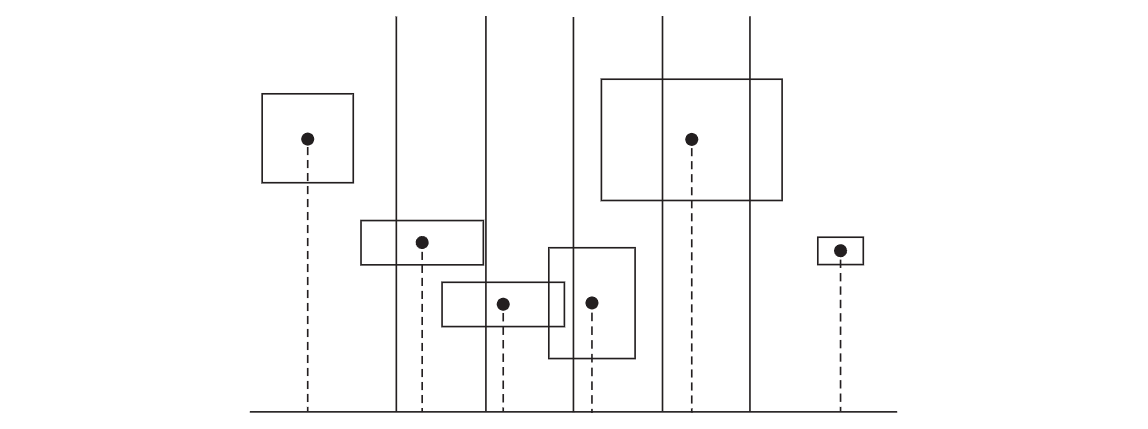
这种利用桶分割的算法叫做Binned SAH.
最后对分割出的两个子节点递归地做这个算法,直到节点中物体个数小于规定的数目(此数目也是人为配置)。
实际实现中有些小优化:
- 一般会有一个Bucket结构用来存储此桶内所有物体的BV的merge。这样,对于任意分割线,我就只需要将线一边所有桶的BV合并即可,而不需要再判断哪些物体在边一侧,也不需要真正将物体存在桶内。
- 我们假设从左往右检查分割线,那么可以用一个
right数组用来存储每条线右边的所有BV的并。对于某条线,其左边的BV可以用上条线左边的BV与两线之间桶的BV合并得到,而右边的BV则可以直接读right数组得到,节省了BV合并计算。
中位数和SAH算法的结果对比#
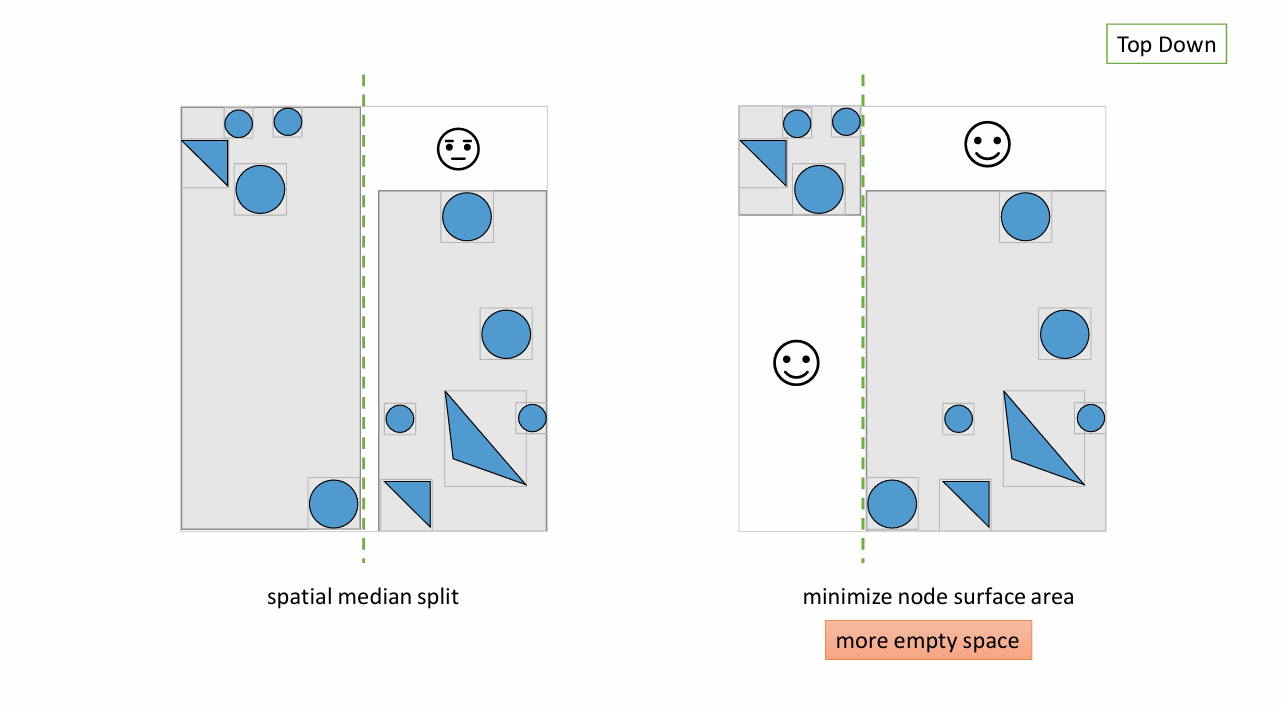
一般来说使用SAH可以构建出更紧凑的BVH,查询效率更高。
PhysX则有三种做法:
BVH_SPLATTER_POINTS:默认做法,直接拿到节点AABB的中点($(AABB_{maxi} + AABB_{min_i}) * 0.5$)BVH_SPLATTER_POINTS_SPLIT_GEOM_CENTER:节点内所有物体AABB中心的平均值- SAH
从上往下速度依次减慢。而策略是用户可配置的。
而他也不是拿到最长轴上的值,而是拿方差最大的值:
$$ s^2 = \frac{\sum(x_i - \bar{x})^2}{n - 1} $$其中$n$是节点内物体数量,$x_i$是某物体的AABB中心坐标(是的他是个Vector3),而$\bar{x}$就是$x_i$的均值。
最后取$s^2(x,y,z)$中值最大的轴。这看上去算得很慢,但PhysX用SIMD加速优化了,实际很快。
LBVH#
Linear BVH。比起Binned BVH的优点是:
- 可以多线程并行构建
- 可以很好地在GPU上构建(这部分不作讨论)
此方法基于BottomUp构建方式,采用Morton Code4进行编码以加速构建。
Morton Code#
又叫做Z-Curve4。是一种将空间划分成网格,并将网格坐标用二进制表示的编码。
以$R^2$为例。假设将空间划分成均匀的网格。那么可以用二进制作为这些网格的坐标:
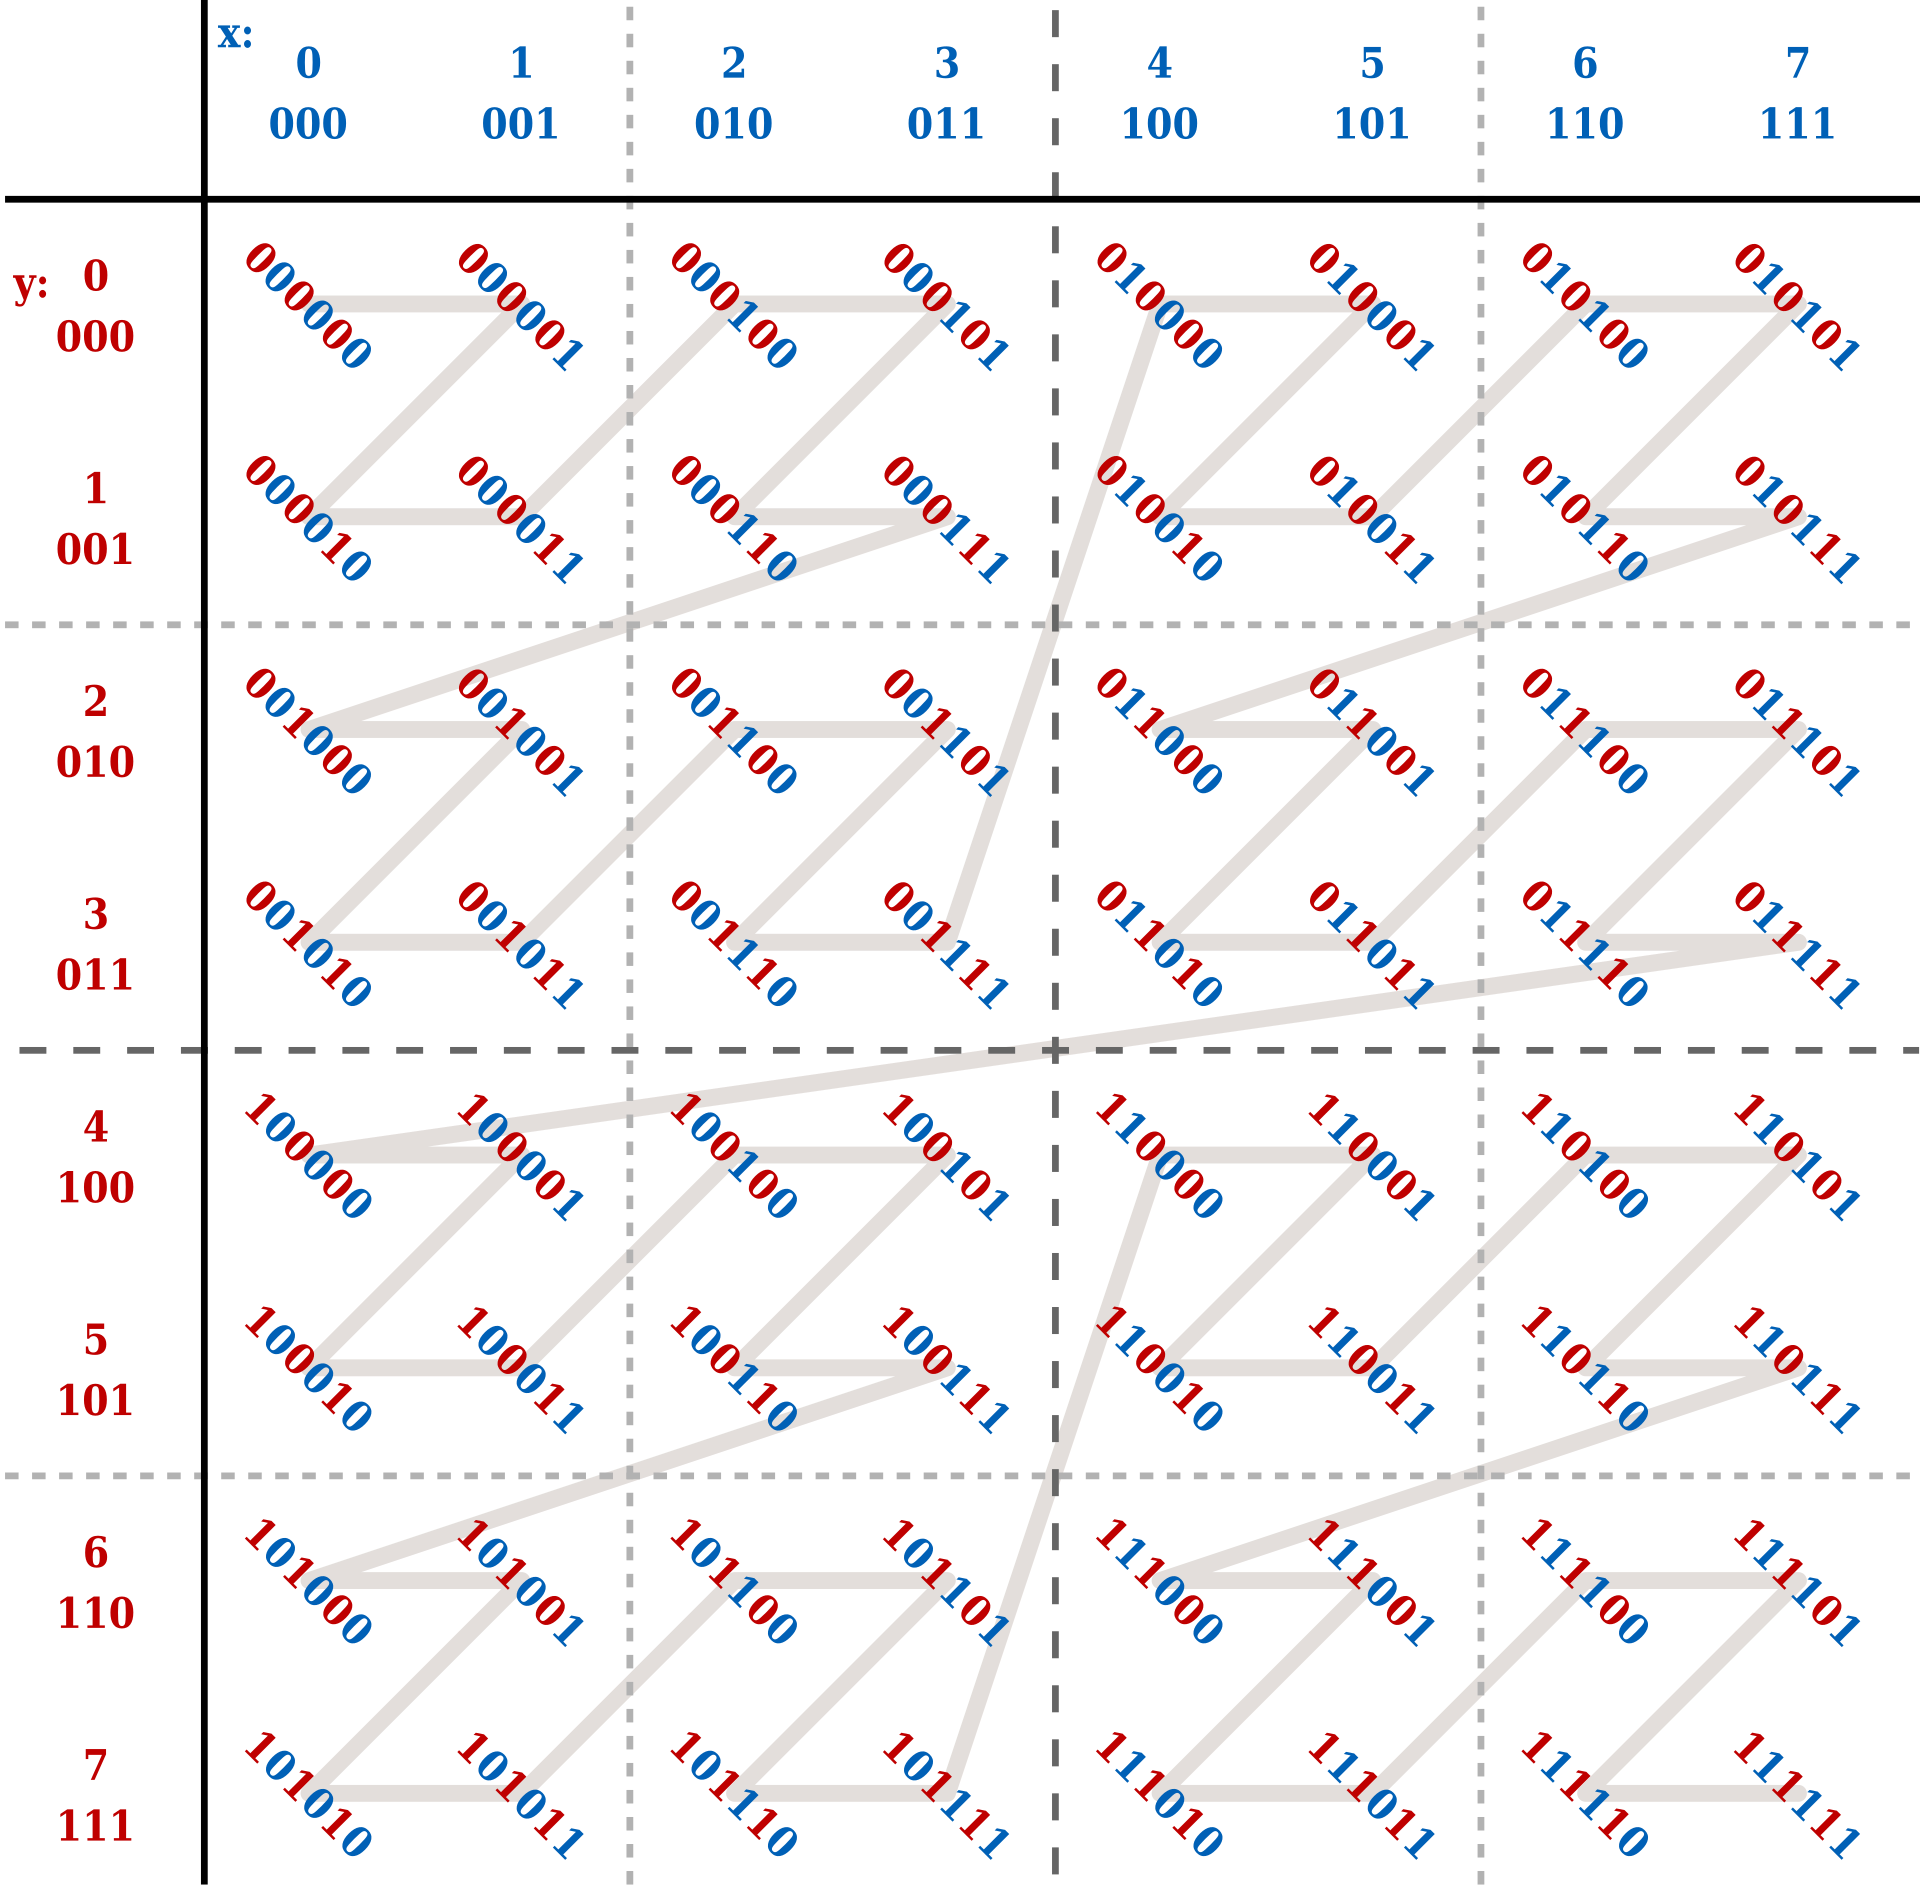
这里x轴上的网格序号是$1, 2, 3, …$对应二进制$0001, 0010, 0011, …$。y轴上也是同理。这样就可以用x和y表示网格上的点:
$$ \begin{aligned} & y[] = x[] = \{0000, 0001, 0010, 0011, 0100 , \cdots \} \\ \end{aligned} $$其中某个点用x和y的二进制交替表示。假设将二进制的每一位记为$x_i$即$x = x_4x_3x_2x_1$。那么对于$x = x_4x_3x_2x_1, y = y_4y_3y_2y_1$的点的二进制表示就是
$$ p(x, y) = y_4x_4y_3x_3y_2x_2y_1x_1 $$$R^3$下就是先x后y再z的交替表示。
使用这种表示方式的好处是:连续的$p(x, y)$值在空间上表示一小团(一簇)空间中的点。
比如看上图中第一个大格子(第一个$Z$),这个格子里面存储四个小点,他们的值是连续的$0000 \sim 0011$。
你也可以按照4个格子(4个$Z$,即16个点)为一簇进行划分。那么以左上角8个为例,他们就是$0000 \sim 1111$。其实只要定下最高的非0位,那么其下的所有格子就都是连续的。比如定下最高位是第4位,那么$1000 \sim 1111$的所有格子就能组成一个簇。也就是说Morton码以$2^n$为边界分割簇。
以往格子的存储都是以矩阵方式,按行或列存储。而Morton码则将格子按簇存储。
那么在确定了$x, y$之后,如何计算两者交错的Morton Code呢?有两种方法:
- 朴素法:硬算,将$x,y$位交替拼接
- Spread-And-Merge:先把单个轴的位摊开(每隔1位插一个0,$R^3$下是每隔2位插一个0),再把各轴的结果或起来:
// 2D:
uint64_t Part1By1(uint32_t x) {
    x = (x | (x << 16)) & 0x0000FFFF0000FFFF;
    x = (x | (x << 8))  & 0x00FF00FF00FF00FF;
    x = (x | (x << 4))  & 0x0F0F0F0F0F0F0F0F;
    x = (x | (x << 2))  & 0x3333333333333333;
    x = (x | (x << 1))  & 0x5555555555555555;   // 位已被均匀摊到偶位
    return x;
}
uint64_t EncodeMorton2(uint32_t x, uint32_t y) {
    return (Part1By1(y) << 1) | Part1By1(x);
}

// 3D:
uint32_t Part1By2(uint32_t x) {
    x &= 0x3FF;                         // 由于uint32_t限制,x,y,z分别最多只能取10位
    x = (x | (x << 16)) & 0xFF0000FF;
    x = (x | (x << 8))  & 0x0300F00F;
    x = (x | (x << 4))  & 0x030C30C3;
    x = (x | (x << 2))  & 0x09249249;   // 摊到位置 0,3,6,...,27
    return x;
}
uint32_t EncodeMorton3(uint32_t x, uint32_t y, uint32_t z) {
    return (Part1By2(z) << 2) | (Part1By2(y) << 1) | Part1By2(x);
}
用了一些老八秘制位运算小技巧。
LBVH构建#
而LBVH构建的第一步就是:
- 将所有物体的BV合并变成大BV,然后将这个BV在各轴上划分成10x10x10的网格(如果你是
uint64_t那可以20x20x20,取决于你的数据宽度)。 - 然后看各个物体的BV中心落在哪个网格内,并对其进行Morton编码。
然后对所有MortonCode进行排序。这里十分推荐使用基数排序(RadixSort),有如下理由:
- 性能高:复杂度$O(n)$。由于我们这里的二进制位数固定(假设为
uint32_t),PBRT里面是64个桶($2^6$),每次放6位进去排,排6次全部排完。 - 稳定排序:这样跨平台/跨线程的排序结果是确定的。
接下来按Morton Code进行二分拆分以构建两颗子树。从最高位往最低位进行切分。由于每个二进制位只有0和1,那么为0的所有元素就可以放到左节点,而1的就放到有节点咯。
比如说,现在有元素:
$$ \begin{aligned} & A = (0, 0) = 0000 \\ & B = (1, 0) = 0001 \\ & C = (0, 1) = 0010 \\ & D = (3, 0) = 0101 \\ & E = (2, 2) = 1010 \\ & F = (3, 2) = 1111 \\ \end{aligned} $$那么从最高位开始,首先将第四位按0和1分开,那么$A, B, C, D$就在左子树,$E,F$就在右子树。 接下来对剩下的左右子树,看第三位。那么$B,C$就是一边,$D$ 是另外一边。$E$和$F$也被分开,以此类推:
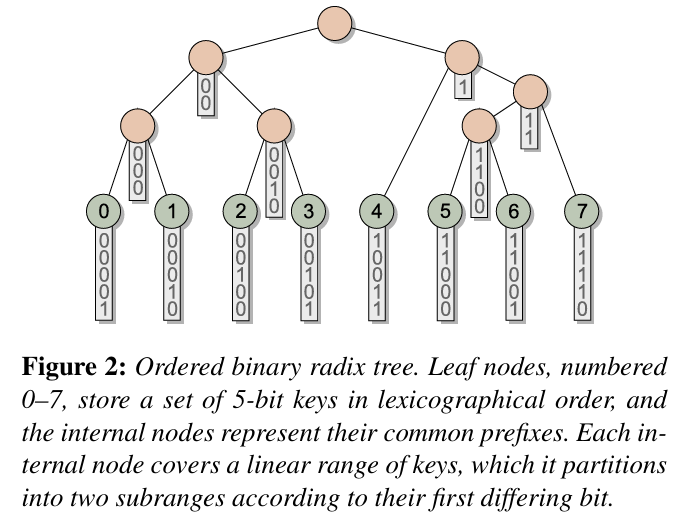
这看似是一个二分的递归方式。但LBVH之所以叫Linear BVH,就是因为本质上所有Morton Code都在一个数组里面,这里的切分也只是在这个数组里面找不同的区间而已,不需要搬运任何的元素。在LBVH的论文中5使用了一种并行方式快速构建:
首先可以并行地算$\delta_i$数组:
$$ \begin{aligned} & \delta(i, j) = \operatorname{clz}(MortonCode_{i} \text{ XOR } MortonCode_j) \end{aligned} $$这里$\operatorname{clz}$是“找到二进制数字中最高位1前面还有多少个0”。所以这里是对任意两个Morton Code做异或,然后找最高位1前还有多少个0.
然后定义$d$:
$$ d(i) = \text{sign}(\delta(i, i+1) - \delta(i, i-1)) $$即比较第$i$个Morton code和他相邻的码的$\delta$谁更长。
算法的步骤如下:
首先对于任意的$i$,他都可以构成一颗节点:
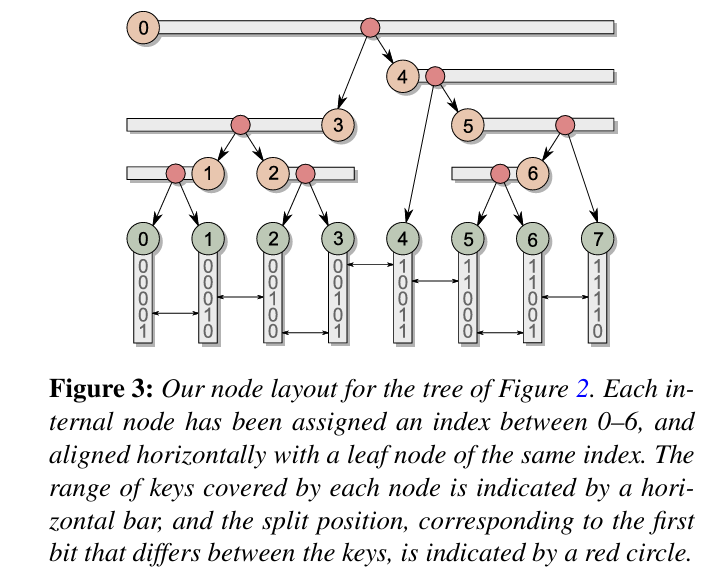
- 首先找到对应的$d(i)$,如果$d(i) \gt 0$,那么此时找到节点的左端点,我得往右找。否则往左找。
- 假设往右找。那么不停地找满足$\delta(i, k) \gt \delta_{min}, \delta_{min} = \delta(i, i-d)$的$k$。这样就找到此节点的右端。(左端同理)。这样左右两端的物体就都在同一个节点中。
- 接下来要找到此节点的二分位置。$\delta(i, k)$是整个节点的容纳长度,这里在当前节点范围内找到最大的$s$满足$\delta(i, i+sd) \gt \delta(i, k)$(这里可用二分查找加快效率)。这样分裂点$\gamma = i + s\cdot d + \min(d, 0)$就找到了
如果整个Morton code的个数是$n$,那你完全可以开$n-1$个线程并行地去执行这个过程,那么很简单就能找到所有节点了。
但可以看到这里等于是不停地二分节点,所以最后叶子节点中只会包含一个物体。这比起SAH方式会产生更多的节点。但这种大规模并行很有利于GPU去做,所以LBVH一般是在GPU上做。
伪代码在论文5中都写的很清楚了。我就不再写实现了。游戏物理引擎中除非你要将BVH搬到GPU上,一般也不会实现这个。能实现基于SAH的就行了。
HLBVH#
融合了Binned SAH和LBVH两个做法。
在对Morton Code排序完之后,不是直接进行二分拆解,而是选定簇,对每一簇并行构建当前的BVH节点。PBRT中是用高12位相同的morton code作为一簇:
mask = 0b00111111111111000000000000000000;   // 高 12 位
for (start=0, end=1; end <= n; ++end) {
    if (end == n  ||  (morton_codes[start] & mask) != (morton_codes[end] & mask)) {
        treelets.push_back({start, end - start});   // 一个簇 = [start, end)
        start = end;
    }
}
某一簇我们称为$treelet_i$。在确定好簇之后,再在簇内再用LBVH构建法。
在分完$treelet_i$之后,各个个$treelet_i$内的二分就可以并行执行了。
那么每个$treelet_i$最后都会构建一颗属于自己的独立的树。这时可以将所有$treelet_i$视为独立的元素(独立的BV),这样问题就变成如何对这些BV进行BVH构建。这里可以使用Binned SAH构建法。
这个算法的好处是:
- 可以利用LBVH的并行
- 构建更好的BVH:因为越靠近树顶的BV范围越大,越决定BVH的质量。相比于LBVH简单粗暴的二分,使用SAH可以在这方面更好地提高树质量
Incremental BVH#
增量式BVH。上面说的BVH一般都用于纯静态场景,构建一次即可。在游戏物理引擎中一般用于存储静态物(但当静态物增加/删除时仍旧得重建BVH)。但物理引擎中还有很多的动态物,他们的位置时时刻刻都在改变。所以我们必须有一种增量式构建BVH的方法。
在我的演示中(文末有),在有一万个物体的情况下,增加一个物体的耗时大概是0.07~0.1ms左右(但是我没做树旋转操作)。
Erin Catto在他的GDC分享中1中有说到三种处理移动物体的BVH构建:
- Refit ancestores(重适配)6:当物体移动,将其重新挪到新节点下,或扩大/缩小父节点及祖先节点。但这样很慢,而且可能导致整颗BVH树的质量越来越低(可能导致节点之间重叠区域越来越多)
- Rebuild subtrees(重构建子树):很慢,不推荐
- Remove/Re-insert(删了然后再插入):也很慢,但是可以将时间摊平到多帧(每帧重新插入一点物体)
所以他推荐第三种方法。
在已有的BVH上插入新物体的一种方式如下(PhysX版):
- 从树顶往下,不停地找节点BV中心离新物体BV中心最近的那个节点。一直走到叶子节点
- 如果叶子节点中物体没到上限,就将此物体放进去,并且更改此叶子节点和其所有父节点的BV
- 如果到达上限,就将物体加入,然后对此叶子节点做一次BVH构建,以将其分裂成两个新节点
Goldsmith-Salmon算法7则提出了一种启发式的选择子节点的方法:
其原理其实就是SAH的原理:一条随机射线与一个包围盒相交的概率 ≈ 两者表面积之比(后来被 MacDonald & Booth 1990 形式化为 SAH)。所以插入时应该优先最小化树中各处包围盒表面积的膨胀——盒子越紧凑,射线误入该子树的概率越低。
具体做法如下,对树中每个候选插入物体$N$计算:
- 节点的表面积增量$\Delta S_A$:即将$N$放入此节点后此节点表面积的增量
- 射线访问此节点的概率:$P = \frac{S_A(N)}{S_A(Root)}$,为当前节点的表面积(未插入N)比上根节点的表面积
那么$cost = \Delta S_A \cdot P$。每次都选取$cost$最小的那个节点。
可以看到这比PhysX的做法要慢上一些。
树的旋转#
对于树插入,显然可能会导致树退化成链表的情况。这个时候就可以用树旋转8来将树转成更平衡的树。
其实就是AVL或红黑树里面的旋转操作,原封不动地套用到BVH来了。
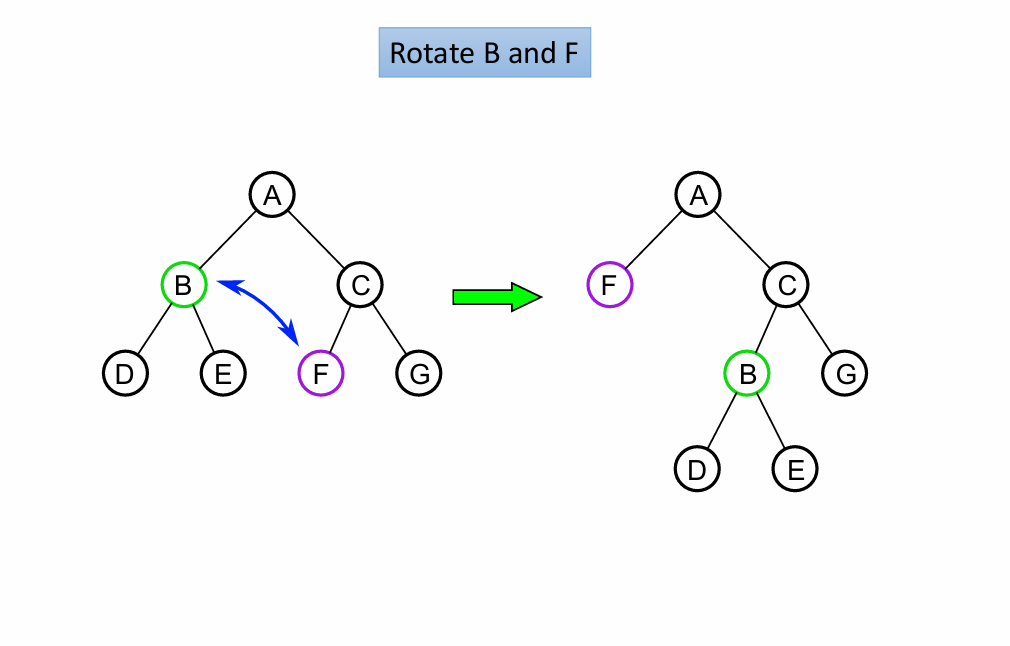
只是旋转之后的子树要重新算其父节点/祖先节点的BV。
而决定到底转不转是用SAH:
- 每个候选旋转(有四种,见Catto的GDC分享9)都算旋转前/后的 SAH 成本(该局部子树的表面积和)
- 只有当成本变小才执行,否则放弃
- 扫描方式是自底向上遍历整棵树,对每个内部节点尝试四种旋转配置,可以反复多轮直到不再改进。
论文8中说最好做旋转,旋转之后无论树来自SAH还是LBVH构建,旋转之后都能显著降低SAH成本,提升Raycast性能。
而PhysX则是在插入节点时,看两个子节点的体积比是否大于3。如果大了就在插入之后做一次旋转。
低移动物体的优化#
如果物体移动速度较低,那么通常不会移动到很远的地方。所以Erin Catto的建议是给每个物体一个更大的BV。在构建BVH时用这个大BV,而当物体本身BV移出这个大BV时,才重新走BVH构建。
何时构建BVH#
由于BVH一般用于SceneQuery,所以当增加/删除/移动物体时,将物体Pending下来,只有当有任意SceneQuery发起的时候,才重新构建树或增量构建树。
PhysX甚至有一套算法,可以将构建树的操作摊平到多帧,以防止一帧内突然出现卡顿。
演示#
进去后左边Example列表中往最下面翻,有三个例子:
BVH:拥有一万个物体的Binned BVH构建Interactive BVH:可以从头开始一步一步增加物体以进行Binned BVH构建Increasement BVH:从头一步一步开始增加物体或生成一堆物体以进行Increasement BVH构建(未实现树旋转) 每次重做还会在右边面板显示重做时间。下方的BVH树结构,点击节点会在场景中绘制出当前BVH节点的BV,以及高亮其容纳的物体。
《On fast Construction of SAH-based Bounding Volume Hierarchies》(RT 2007) ↩︎
Maximizing Parallelism in the Construction of BVHs, Octrees, and k-d Trees ↩︎ ↩︎
Wald, Boulos, Shirley 2007《Ray Tracing Deformable Scenes Using Dynamic BVHs》 ↩︎
《Automatic Creation of Object Hierarchies for Ray Tracing》 ↩︎
Andrew Kensler, “Tree Rotations for Improving Bounding Volume Hierarchies”, IEEE Symposium on Interactive Ray Tracing (RT) 2008 ↩︎ ↩︎