本文记录了最优化理论(对偶,KKT)和LCP问题相关知识。
理论来自Boyd的《Convex Optimization》。
最优化问题定义#
最优化问题,是指在可能含有不同约束的情况下,求某个函数的最值问题:
$$ \begin{aligned} & \text{minimize} && f_0(x) \\ & \text{subject to} && f_i(x) \le 0, \quad i = 1 \dots m \\ & && h_j(x) = 0, \quad j = 1 \dots p\\ \end{aligned} $$这里$f_0(x)$就是要求最值的目标函数,一般是求最小值(如果是最大值,求$-f_0(x)$的最小值就行)。
$f_i(x) \le 0,\; i = 1 \dots m$ 则是不等式约束。
$h_i(x) = 0$ 则是等式约束。
或者将等式约束写成矩阵形式$Ax = b$也可以:
$$ \begin{aligned} & \text{minimize} && f_0(x) \\ & \text{subject to} && f_i(x) \le 0, \quad i = 1 \dots m \\ & && Ax = b\\ \end{aligned} $$当没有任何约束时,叫做无约束优化。这种优化的方法我们已经知道一些了,例如梯度下降法。所以我们主要研究含有约束的优化。
对于任意的最优化问题,可以构造拉格朗日函数:
$$ L(x, \lambda, v) = f_0(x) + \sum_{i = 1}^m \lambda_i f_i(x) + \sum_{i=1}^p v_i h_i(x) $$然后构造对偶函数,此函数是在$L(x, \lambda, v)$关于$x$取最小时的函数:
$$ \begin{aligned} & g(\lambda, v) = \inf_{x \in D}L(x, \lambda, v) = \inf_{x \in D}( f_0(x) + \sum_{i = 1}^m \lambda_i f_i(x) + \sum_{i=1}^p v_i h_i(x)) \\ & \text{其中 } \lambda_i \succeq 0 \end{aligned} $$这里$D$是所有满足约束的$x$的作用域。$\inf$是infimum(下确界)符号。
此对偶函数有如下良好性质:
- 一定是凹函数:这意味着他一定有唯一最大值,并且局部最优解就是全局最优解
- 如果将原问题$f_0(x)$的最小值记为$p^*$,那么$g(\lambda, v) \le p^*$恒成立
这意味着能通过$g(\lambda, v)$确定$p^*$的一个下界。
那么,如果能找到$g(\lambda, v)$的最大值$d^*$,并且$d^* = p^*$的话,我们就可以将原优化问题转换成研究$g(\lambda, v)$的最大值问题,而且他还是凹函数,有很多现有的算法可以直接作用上。这个问题就叫对偶问题。即将原问题的最值转换成找对偶函数最值的问题。
$d^* \le p^*$这个事情称为弱对偶性。这时,$p^{*} - d^{*}$称为 最优对偶间隙 。
而如果$d^* = p^*$,则称为强对偶性。
弱对偶性一定存在(只要拉格朗日函数良定义),他可以给出原问题的一个下界。
而强对偶性则不一定满足。而如果满足,我们就可以通过研究对偶函数来找到原问题的最值。这是我们最希望看到的情况。
注意这里$g(\lambda, v)$是在关于$x$取最小时的函数。他是不包括$x$本身的。
比如找到如下问题的对偶函数:
$$ \begin{aligned} & \text{minimize} && x^T x \\ & \text{subject to} && Ax = b \\ \end{aligned} $$此时拉格朗日函数为
$$ L(x, v) = x^Tx + v(Ax - b) $$要找到他的最小值,只需要对$x$求导,然后令导数为0:
$$ \begin{aligned} & \nabla_xL(x, v) = 2x + A^Tv = 0 \\ & \Rightarrow \\ & x = -\frac{A^Tv}{2} \\ \end{aligned} $$解出$x$之后,将$x$带入拉格朗日函数才能得到最后的对偶函数$g(v)$。
也就是说,解对偶问题的过程是:先求关于$x$的最小值,然后再求对偶函数的最大值。
接下来介绍强对偶性判定,但必须先介绍一些概念:
凸性和仿射#
“凸”在不同语境下不一样:
- 凸函数:$\frac{f(x_1) + f(x_2)}{2} \ge f(\frac{x_1+x_2}{2})$的函数。一般来说是开口向上的函数
- 凸集:集合中任意两点的连线线段上的所有点仍在集合中
凸集$C$的数学定义为:
$$ \begin{aligned} & \forall x_1, x_2 \in C, \theta \in [0, 1] \\ & \theta x_1 + (1 - \theta)x_2 \in C \end{aligned} $$如果对$\theta$的取值不做任何要求的话($\theta \in R$),集合$C$就是仿射集。
使用 $\operatorname{co} C$表示任意集合$C$对应的凸集(是$C$构成的凸包)
使用$\operatorname{aff} C$表示任意集合$C$对应的仿射集(即$C$构成的仿射包)。
比如空间中的线段就是凸集,而直线则是仿射集。
接下来定义内部和相对内部:
集合$C$的内部 $\operatorname{int} C$:
$$ \operatorname{int}C = \{ x\in C : \exists r > 0, B(x, r) \subset C \} $$集合$C$的相对内部 $\operatorname{relint} C$:
$$ \operatorname{relint}C = \{ x \in C : \exists r > 0, B(x, r) \cap \operatorname{aff} C \subset C \} $$
其中
$$ B(x, r) = \{y:||y - x|| \lt r\} $$人话就是:内部,就是指$C$中某些点构成的集合,这些点的的某个去心邻域(以此点为球心所在小球)内的所有点都得在$C$中。
而相对内部,则更宽松一些,他只要求某点去心邻域和$C$的仿射集的交集中的所有点在$C$中。
举些例子:
- 比如一维线段$[0, 1]$的内部就是$(0, 1)$。其相对内部也是$(0, 1)$
- 而二维线段就没有内部(因为线段上任意一点的邻域内总有不在线段上的点)。但是他有相对内部(为此线段本身,去掉两个端点)。因为线段的仿射集是线段所在直线,和任意线段上的点的邻域的交集一定在线段上。
“内部”,其实就是物体去掉边界后剩下的部分。而在$R^n$维空间下,所有$R^{n-1}$维的物体都没有内部(比如三维空间下的线,面)。这显然是不太合理的,所以通过定义相对内部来补足这部分。也就是说,相对内部其实就是在物体本身维度下定义的内部。
而有些集合没有边界。此时,定义闭包($\operatorname{cl} C$) 为将其边界补上之后的集合。
而 相对边界($\operatorname{cl} C \setminus \operatorname{relint} C$) 则是闭包去掉相对内部后留下来的部分。从符号上也能看出($\setminus$是集合差的符号)。
常见凸体#
除了直线/线段之外。还有如下常见凸体。
- 超平面 $\{x:a^Tx = b\}$:其中$a^T$是此平面的法向量。只是将三维平面扩展到任意维度。超平面即是凸的也是仿射的。
- 半空间$\{x : a^Tx \le b\}$:就是由超平面划分的两个空间。半空间是凸的,但不是仿射的。
- 欧几里得球体$\{ x : ||x - x_c||_2 \le r \}$
- 欧几里得椭球$\{x : (x - x_c)^T P^{-1}(x - x_c) \le 1\}$:其中$P$是正定矩阵。显然这其实是一个二次型。$P^{-1}$只是告诉我们$P$是可逆的,这里写成$P$也行。
- 范数球$\{x:||x - x_c|| \le r\}$:即将球的定义推广到任意范数
- 范数锥$\{(x, t): ||x|| \le t\}$:是一个锥体
- 多面体$\{x: a_i^T x \le b_i,\; i = 1 \dots m, c_i^T x = d_i,\; i = 1 \dots p \}$:由多个半空间交集构成内部,由多个超平面构成边界。也可以用矩阵表示成更紧凑的形式$\{x: Ax \preceq b, Cx = d\}$。这里$\preceq$是偏序小于,表示按分量比较向量。
- 锥体:如果对任意$x \in C, \theta > 0$,都有$\theta x \in C$,那么$C$就是锥体
凸问题#
如果$f_i(x),\; i = 0\dots m$是凸函数,而$h_i(x)$是仿射函数,那么原优化问题为凸问题。
即目标函数,不等式约束中的函数都得是凸的,而等式约束中的函数需要是仿射的。
最优性条件#
作用在算法的解上。算法的解必须满足这种条件才是局部最优解。
KKT条件#
如果$x$是原问题的可行解,且$(\lambda, v)$是对偶函数的可行解,那么显然有:
$$ f_0(x) - p^{*} \le f_0(x) - g(\lambda , v) $$一般也将不等式右边记为$\epsilon$,而将上面这个条件称为 $\epsilon$-次优 。
这时,将$f_0(x) - g(\lambda, v)$称为 对偶间隙, 而 $p^{*} - g(\lambda, v)$ 则是 最优对偶间隙。
这在某些优化算法中可以给出一种停止准则。比如某个算法给出了一系列的可行解$x^{(k)}$,那么,我们可以手动给出一个精度$\epsilon$,只要对偶间隙小于此精度算法就停止:
$$ f_0(x^{(k)}) - g(\lambda^{(k)}, v^{(k)}) \le \epsilon $$或者使用相对容差:
$$ g(\lambda^{(k)}, v^{(k)}) > 0, \frac{f_0(x^{(k)}) - g(\lambda^{(k)}, v^{(k)})}{g(\lambda^{(k)}, v^{(k)})} \le \epsilon_{rel} $$或
$$ f_0(x^{(k)}) > 0, \frac{f_0(x^{(k)}) - g(\lambda^{(k)}, v^{(k)})}{-f_0(x^{(k)})} \le \epsilon_{rel} $$这样,可以保证相对误差小于等于$\epsilon_{rel}$。
其实这种算法早已见过。在GinoGJK中就有这种方式。
接下来介绍互补松弛性:
假设$(\lambda^{*}, v^{*})$是对偶问题的最优解,由于存在如下不等式:
$$ \begin{aligned} g(\lambda^{*}, v^{*}) & \\ & = \inf_x (f_0(x) + \sum \lambda^{*}_i f_i(x) + \sum v^{*}_i h_i(x)) \\ & \le f_0(x^{*}) + \sum \lambda^{*}_i f_i(x^{*}) + \sum v^{*}_i h_i(x^{*}) \\ & \le f_0(x^{*}) \end{aligned} $$这里最后两个不等式是因为约束条件:$h_i(x^{*}) = 0$和$\lambda_i^{*} > 0, f_i(x^*) \le 0$得到。
而如果问题满足强对偶关系,那么又有:
$$ f_0(x^{*}) = g(\lambda^{*}, v^{*}) $$这就导致上面不等式最后的$\le$会变成$=$。这就意味着必定有 $\sum \lambda_i^{*}f_i(x^{*}) = 0$,那么一定有
$$ \begin{aligned} \lambda_i^{*}f_i(x^{*}) = 0 \end{aligned} $$这个条件就叫互补松弛条件。即必须满足下面两个条件其中一个:
$$ \begin{aligned} \lambda_i^{*} > 0 & \Rightarrow & f_i(x^{*}) = 0 \\ f_i(x^{*}) < 0 & \Rightarrow & \lambda_i^{*} = 0 \\ \end{aligned} $$互补松弛说的是“两个量不能同时为正,至少有一个为0(或者两者都为0)”
现在,可以介绍 KKT最优性条件:
假设$f_0, \dots, f_m, h_1, \dots, h_p$都可微,那么KKT条件是:
$$ \begin{aligned} & f_i(x^{*}) \le 0, \quad i = 1, \dots, m \\ & h_i(x^{*}) = 0, \quad i = 1, \dots, p \\ & \lambda^{*}_i \ge 0, \quad i = 1, \dots, m \\ & \lambda^{*}_i f_i(x^{*}) = 0, \quad i = 1, \dots, m \\ & \nabla f_0(x^{*}) + \sum_{i=1}^m \lambda_i^{*}\nabla f_i(x^{*}) + \sum_{i=1}^p v_i^{*} \nabla h_i(x^{*}) = 0 \end{aligned} $$前两个就是约束条件,第三个是对偶问题的条件,第四个是互补松弛条件。
而最后一个条件,是因为要求$L(x, \lambda, v)$的极小值,那么必须令其导数为0。
KKT条件是求解带约束最优解的必要条件。KKT条件可以推出当前解是局部最优解,而局部最优解不能推出KKT。而当问题是凸问题时,KKT条件是充要条件。
也就是说,在强对偶性下,你算法每走一步, 每次得到的解必须满足KKT条件(或者至少得在逼近解的时候满足),这样这一步的解才是正确的。
KKT给了我们一个检验算法每一步的解是否正确的条件。他是解的“最优性证书”。
对于非凸问题来说,需要用Hessian判定法进行最值判定。凸优化里面叫二阶条件。
CQ(Constraint Qualification)#
最优性条件(如KKT)要求了算法解的性质。而某些最优性条件本身就需要原问题满足某些性质。比如KKT条件要求原问题是强对偶的。
这种约束在问题上的条件就叫约束规范性条件(CQ)。
CQ有很多种,用于不同类型的优化问题。这里只记录一些。
全局凸性条件#
只作用于凸问题
强对偶性判定(Slater约束准则)#
对于一般情况,强对偶性往往不成立。但如果原问题是凸问题,就可以用Slater约束准则进行判断:
Slater条件是:
$$ \begin{aligned} & \exists x \in \operatorname{relint} D \\ & f_i(x) < 0, \quad i = 1, \dots m \\ & h_i(x) = 0 \end{aligned} $$满足此条件时,凸问题有强对偶性。
人话:只需要在可行域内找到一个不在可行域边界上的内点满足优化问题的条件即可。
而当不等式约束中存在仿射函数时,Slater条件可以更弱(假设前$k$个不等式约束是仿射函数):
$$ \begin{aligned} & \exists x \in \operatorname{relint} D \\ & f_i(x) \le 0, \quad i = 1, \dots k \\ & f_i(x) \lt 0, \quad i = k+1, \dots m \\ & Ax = b \end{aligned} $$Slater判定是强对偶的充分条件,强对偶并不能推出Slater条件。
局部几何型CQ#
可以作用于任意问题(不要求是凸的)。
即使在凸问题上,当Slater判据失效时,下列CQ仍可能成立。
LICQ#
为线性无关约束。即要求在$x^{*}$处活跃约束的梯度线性无关:
$$ \{ \nabla f_i(x^{*}), \nabla h_i(x^{*}) \} \text{线性无关} $$是KKT成立的必要条件:
如果LICQ成立,那么KKT条件成立。但如果LICQ失败,KKT仍旧可能成立。
MFCQ#
比LICQ更弱:
只要求等式约束的梯度线性无关。但是要求存在方向$d$,使得我能“同时远离所有卡住我的不等式边界”:
$$ \begin{aligned} & \{\nabla h_j(x^{*})\} \text{线性无关} \\ & \exists \vec{d}, \nabla h_i(x^{*})^T\vec{d} = 0 (\forall j), \nabla f_i(x^{*})^T\vec{d} \lt 0 (i \in I(x^*)) \\ & I(x^{*}) = \{i \in \{1, \cdots, m\}: f_i(x^{*}) = 0\} \end{aligned} $$$I(x^{*})$是“活跃集”,在点 $x^{*}$ 处,恰好取等号的那些不等式约束的下标集合。
即要求存在方向$d$,其和等式约束的梯度夹角为0, 和不等式约束的梯度夹角为锐角。
线性/仿射约束#
如果所有约束都是仿射的,那么KKT总是成立。
Fritz-John条件#
又叫FJ条件。是一种更一般,更宽松的条件。他和KKT不一样,不是“最优性证书”。他只能排除候选的解,但不能证明解是最优的。
条件为:
$$ \begin{aligned} & \text{平稳性:} && \lambda_0 \nabla f_0(x^{*}) + \sum_{i=1} \lambda_i \nabla f_i(x^{*}) + \sum_{i=1} v_i \nabla h_i(x^{*}) = 0 \\ & \text{对偶可行性:} && \lambda_i \ge 0, \quad i = 0 \cdots m \\ & \text{互补松弛:} && \lambda_i f_i(x^{*}) = 0, \quad i = 1, \cdots, m \\ & \text{非平凡性:} && (\lambda_0, \lambda_1, \cdots, \lambda_i, v_1, \cdots, v_i) \ne 0 \\ & \text{满足原问题条件:} && f_i(x^{*}) \le 0, \quad i = 1, \dots, m \\ & && h_i(x^{*}) = 0, \quad i = 1, \dots, p \\ \end{aligned} $$平稳性中为目标条件的导数也加了$\lambda_0$。非平凡性则要求拉格朗日乘子至少有一个不为0。
当$\lambda_0 \gt 0$时,FJ条件就变成KKT条件。此时只需将平稳性中等式两边除以$\lambda_0$即可。
FJ作用的问题不需要满足任何CQ。
FJ条件是必要条件,原问题的解是可行解不能推出FJ条件。
解凸优化问题的算法#
不同凸优化的子问题(比如线性规划,二次规划等)有不同的解法。
无约束优化问题解法#
无约束优化问题是最基本的问题。很多有约束的优化问题都可以转变成无约束优化问题解法。
无约束优化问题:
$$ \begin{aligned} &\text{minimize} && f(x) \end{aligned} $$下降法#
对于每步的解$x^{(k)}$,只要满足:
$$ f(x^{(k+1)}) < f(x^{k}) $$就意味着此方法是下降法。
最经典的下降法是梯度下降法。算法总是沿着梯度方向搜索解。
这里先给出下降方向的定义:
满足
$$ \nabla f(x)^T \vec{d} < 0 $$时,$\vec{d}$就是下降方向,也就是说往这个方向走,函数值是下降的。
这里再给出通用的下降法:
给定初始点 $x$ 重复进行 1. 确定下降方向$\Delta x$ 2. 直线搜索。选择步长$t > 0$ 3. 得到新结果$x = x + t \Delta x$ 直到满足停止要求
停止条件一般是 $\nabla f(x) \le \epsilon$,使用一个容差进行停止。
那么这里就有两个问题:
- 下降方向如何确定
- 步长怎么选择最好
梯度下降法中就是使用梯度作为下降方向。但注意其并没有规定步长选择法。
而步长选择则有多种方法:
- 精确直线搜索:$t = \arg \min_{s \ge 0} f(x + s\Delta x)$。将步长视为一个沿着射线$x + t\Delta x$的优化问题。只是这个问题更简单,更容易求解
- 回溯直线搜索:为非精确直线搜索的一种,同样沿着射线$x+t\Delta x$,但做近似优化,只要$f$有足够下降即可。其中回溯法是常用做法: 给定参数$\alpha \in (0, 0.5), \beta \in (0, 1), t = 1$,如果$f(x + t \Delta x) > f(x) + \alpha t\nabla f(x)^T \Delta x$,那么令$t = \beta t$ 回溯法就是沿单位步长$t = 1$开始,逐步缩小范围从而找到$t$。
其中,梯度下降法和最速下降法都是按照梯度方向,区别就在于步长选择。
一般梯度下降法是用非精确线搜索/自适应方法得到步长。而最速下降法则是使用精确线搜索。
不过现在这两个算法也没有分那么细,基本上是同义词了。后文也就不做区分了。
最速下降法有缺点:
在靠近真解的时候,后一次搜索方向与前一次的总是垂直,会出现“锯齿状”的搜索路径。这导致每次迭代进行的距离越来越小,所以收敛速度不快。
牛顿法#
牛顿法使用了二阶梯度,收敛速度更快,但是前置要求也更多。
牛顿方向:
$$ \Delta x = -(\nabla ^2 f(x))^{-1}\nabla f(x) $$注意$\nabla^2 f(x)$是对$f(x)$求两次$\nabla$算子,即Hessian矩阵。那么这里显然要求海森矩阵可逆,并且海森矩阵是正定的(不然$\nabla^2f(x) \ge 0$不一定成立,不满足下降方向)。
注:只要函数二阶可微,海森矩阵就是对称的。而对称正定矩阵一定有逆矩阵,且逆矩阵也是对称正定的。
所以牛顿法在凸优化问题中很好,因为这些条件总是满足的。
但是在非凸问题中就不一定了,所以还有修改版牛顿法(拟牛顿法)。以及由于求海森矩阵很麻烦而发展出来的修正牛顿法。这里就不记录了。
牛顿法主要是研究下降方向,步长还是之前介绍的方法来确定。
只含有等式约束的优化问题解法#
优化问题:
$$ \begin{aligned} &\text{minimize} && f(x) \\ &\text{subject to} && Ax = b \\ \end{aligned} $$常见的方法有拉格朗日乘子法和牛顿法。拉格朗日乘子法也是老生常谈了,就不再赘述了。
牛顿法#
牛顿法是通过将$f(x + v)$在$x$附近泰勒展开变成一个二次优化问题:
$$ \begin{aligned} &\text{minimize} && f(x + v) = f(x) + \nabla f(x)^T v + \frac{1}{2}v^T \nabla^2f(x) v \\ &\text{subject to} && A(x + v)(x + v) = b \end{aligned} $$将这个问题一般化,就变成:
$$ \begin{aligned} &\text{minimize} && f(x) = \frac{1}{2}x^TPx + q^Tx + r \\ &\text{subject to} && Ax = b \end{aligned} $$而此问题的最优性条件是:
$$ \begin{aligned} & Ax^{*} = b \\ & Px^{*} + q + A^T \pmb{\lambda} = 0 \\ \end{aligned} $$注:这里可能对$A^T \lambda$有疑问。因为拉格朗日项是$\pmb{\lambda}^T (Ax - b)$,对其求导数就是$A^T \pmb{\lambda}$。
将其写成矩阵形式为:
$$ \begin{bmatrix} P & A^T \\ A & 0 \end{bmatrix} \begin{bmatrix} x^{*} \\ \pmb{\lambda} \end{bmatrix} = \begin{bmatrix} -q \\ b \end{bmatrix} $$其中系数矩阵叫“KKT矩阵”。
- 如果KKT矩阵非奇异,那么问题存在唯一最优解
- 如果KKT矩阵奇异,但是KKT系统有解,那么任何解都构成最优解
- 如果KKT系统无解,那么此问题无下界或者无解
换到牛顿法中,矩阵形式就是:
$$ \begin{bmatrix} \nabla^2f(x) & A^T \\ A & 0 \end{bmatrix} \begin{bmatrix} \Delta x \\ \pmb{\lambda} \end{bmatrix} = \begin{bmatrix} -\nabla f(x) \\ 0 \end{bmatrix} $$这里其实可以直接解整个方程了。将矩阵乘开,第一行:
$$ \begin{aligned} & \nabla^2f(x) \Delta x + \pmb{\lambda} A^T = -\nabla f(x) \\ & \Rightarrow \\ & \Delta x = -(\nabla^2 f)^{-1}(\nabla f(x) + A^T \pmb{\lambda}) \end{aligned} $$把他带入第二行的$A \Delta x = 0$中可以解出$\pmb{\lambda}$,然后再代回第一行就能解出$\Delta x$了。这样就得到了下降方向。
也有点不可行或约束是非线性的牛顿法。这里就不再赘述了。
含有不等式约束的约束优化问题解法#
罚函数#
被用于内点法和外点法。简单来说,使用罚函数可以将不等式约束融入到目标函数中,使得问题变成一个等式约束问题:
$$ \begin{aligned} &\text{minimize} && f_0(x)\\ &\text{subject to} && f_i(x) \le 0 \\ &\text{subject to} && Ax = b \\ & \Rightarrow \\ &\text{minimize} && f_0(x) + P(f_i(x)) \\ &\text{subject to} && Ax = b \\ \end{aligned} $$罚函数是这样一种函数:当满足约束时,他往往是0(这样目标函数就变回$f(x)$),而当不满足时,离真解差的越远,罚函数的值越大(惩罚越大)。
使用罚函数的方法一般都会尽可能地让惩罚减小,以此来逼近最终解。
内点法(Interior Point Method)#
要求问题严格可行,满足Slater条件。且迭代点始终严格可行。
核心思想是将不等式约束转化成等式约束,从而可以使用牛顿法进行求解。
首先构造一个指示函数(罚函数):
$$ I(x) = \begin{cases} & 0, & f_i(x) \le 0(i = 1, \cdots, m), Ax = b \\ & +\infty, & \text{otherwise} \end{cases} $$也就是说,当满足所有约束时,此函数为0。但是一旦不满足,此函数就暴涨成$+\infty$。
这样,就把原问题变成一个带有等式约束的优化问题:
$$ \begin{aligned} &\text{minimize} && f_0(x) + I(x) \\ &\text{subject to} && Ax = b \\ \end{aligned} $$但是,由于解带有等式约束的优化问题方法都需要目标函数至少一阶可导,所以我们不能直接用这个($I(x)$不可导)。我们可以造一个光滑的障碍函数来近似$I(x)$。一般的选择是:
$$ \phi(x) = -\sum_{i = 1}^m \ln(-f_i(x)) $$想象二维的$\log$函数的图像,他是越靠近$y$轴,值越大。$y$轴就像一道墙一样挡着。所以叫障碍函数:
- 在可行域内部,$-f_i(x) > 0$,所以$\phi(x)$有限
- 越靠近边界$f_i(x) \rightarrow 0$,$\phi(x) \rightarrow +\infty$
这样我们就可以利用障碍函数重述带有等式约束的优化问题,这个问题叫障碍问题:
$$ \begin{aligned} &\text{minimize} && f_0(x) + \mu \phi(x) \\ &\text{subject to} && Ax = b \\ \end{aligned} $$这里$\mu > 0$是障碍参数。简单来说就是调整$\phi(x)$有多近似$I(x)$的参数:
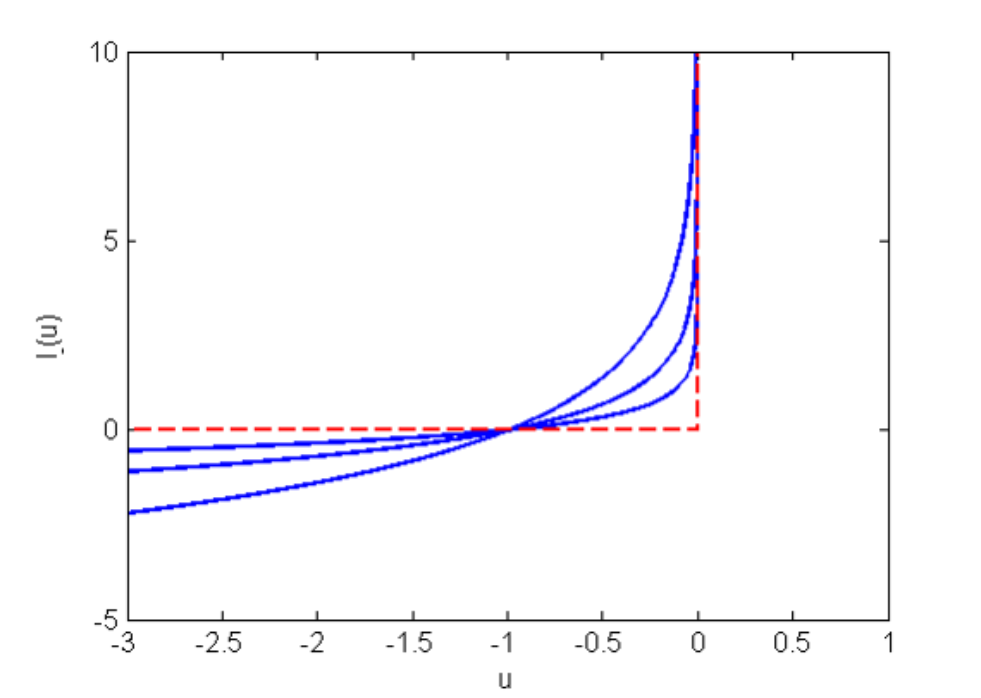
上图中红色就是$I(x)$,而蓝色是不同$\mu$下的$\phi(x)$。可以看到,$\mu$越趋近于0,$\phi(x)$越趋近于$I(x)$。
对于每个$\mu$,假设障碍问题的最优解为$x(\mu)$。那么所有这些$x(\mu)$连城一条曲线,这条曲线就是中心路径:
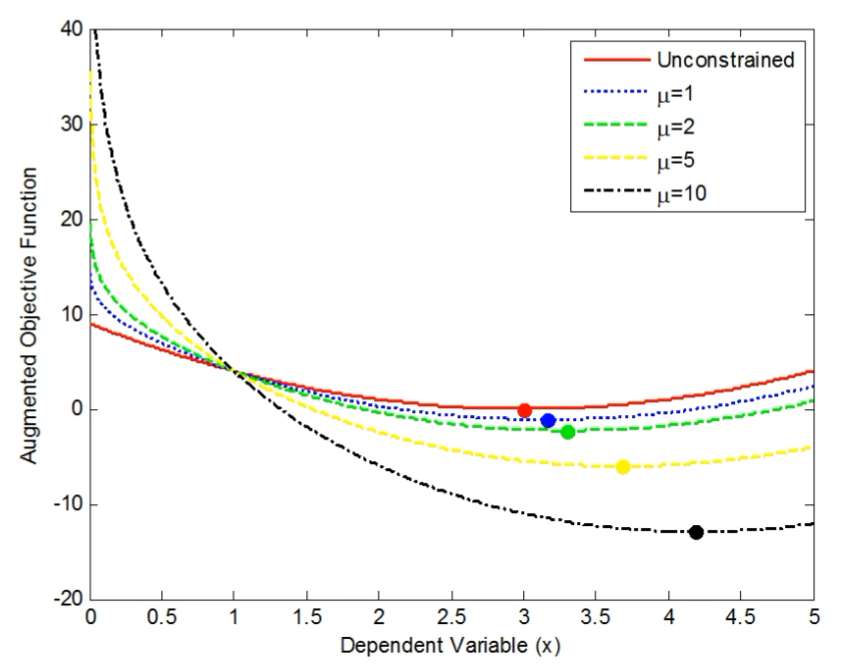
这里加粗的点就是$x(\mu)$。
显然,$\mu$越大,我们离障碍越远,我们的解就越远离真解。
而内点法就是指: 不停地缩小$\mu$,然后去解障碍函数,直到$x$满足停止条件(一般是达到要求的阈值或者到达指定迭代步数):
选择$\mu > 0$,以及严格可行点$x$ 重复: 解障碍问题,得到$x(\mu)$ 减小惩罚参数$\mu = \sigma \mu$ 直到 $m\mu \le \epsilon$
其中$\sigma$是用户给定的参数,$m$是不等式约束个数。$\epsilon$是要求的精度。
这里停止条件是可以被证明的,这里不再证。
内点法之所以叫内点法,就是因为在不停缩小$\mu$时,中心路径会不断从可行域内部跑到真解上。
类似的还有只在可行域边上跑的单纯形法,以及从可行域外逼近真解的外点法。
外点法(Exterior Point Method)#
内点法的缺点是,初始点必须是严格可行的。而外点法就不需要,起点更灵活。而在某些变体中局部收敛速度更快(甚至快于二次收敛速率)。
外点法和内点法相反,从可行域外部逐渐逼近解。
外点法的罚函数一般是:
$$ \sum_{i=1}^m \max(0, f_i(x))^2 $$这样问题就变成:
$$ \begin{aligned} &\text{minimize} && f_0(x) + \rho \sum_{i=1}^m \max(0, f_i(x))^2 \\ &\text{subject to} && Ax = b \\ \end{aligned} $$这里$\rho > 0$。
当满足约束$f_i(x) \le 0$时,$\max (0, f_i(x)) = 0$,没有惩罚。
当不满足时,惩罚是$\rho f_i(x)^2$。
外点法的算法过程是:
选择$\rho > 0$,以及初始点$x_0$($x_0$可以不可行) 重复: 解障碍问题,得到$x_{k}$ 计算违反量。等式是$||h_i(x)||$,不等式是$\max(0, f_i(x))$ 增大惩罚参数 $\rho = \sigma \rho$ 热启动:$x_{k+1} = x_{k}$ 直到 违反量 $\le \epsilon$
注意违反量的计算。理论上是可以将所有等式和不等式的惩罚量加起来,但是等式和不等式可能有不同量纲/尺度,量级打的会淹没另外一个,所以一般是设置两个$\epsilon$,当两个违反量都满足算法就停止。或者使用一个$\epsilon$,但是取所有违反量中最大的:
$$ \max(\max{||h_i(x)||}, \max{\max(0, f_i(x))}) $$因为中心路径的原因,可以使用上一次的结果来热启动,这样可以让算法更快。
内点法也可以热启动,但是要满足额外条件。
那么既然外点法这么好用,他相比内点法有什么缺点呢?
- 由于允许违反约束,这导致在逼近过程中某些点不是严格可行的。这对于要求严格可行的程序(比如物理仿真中不能穿透)就不适合用外点法
- 理论上要$\rho \rightarrow + \infty$才能得到准确解,有限的$\rho$只是近似
- $\rho$很大时,系统会病态,这导致牛顿法/梯度法会变慢。而内点法由于$\mu$是逼近0的,这会让迭代点保持在中心路径的邻域内,从而不容易突然遇到一个病态情况
- 算法停止条件没有“证书”。内点法是可以证明$m\mu < \epsilon$就停止,但是外点法只是小于某个用户参数。
还有很多其他问题,这里就不展开了。
LP问题的求法#
线性规划问题就是所有的函数(目标函数,约束函数)都是线性函数(仿射函数)。所以线性规划一定是凸问题。
线性规划问题有专门的求法。
单纯形法#
标准单纯形法要求所有变量都$\ge 0$,不然不能使用。
这里1有一个十分清晰的示例视频,可以先看一下弄清楚单纯形法的步骤。
一个较为直观的例子#
这里最好使用一个例子来理解单纯形法,假设求解如下LP问题:
$$ \begin{aligned} & \text{maximize} && -x_1 - x_2 \\ & \text{subject to} && x_1 + x_2 \le 4\\ & && 3x_1 + x_2 \le 6 \\ & && x_1 \ge 0 \\ & && x_2 \ge 0 \\ \end{aligned} $$每个约束在二维平面中都是一个半空间,所以我们可以画出来:
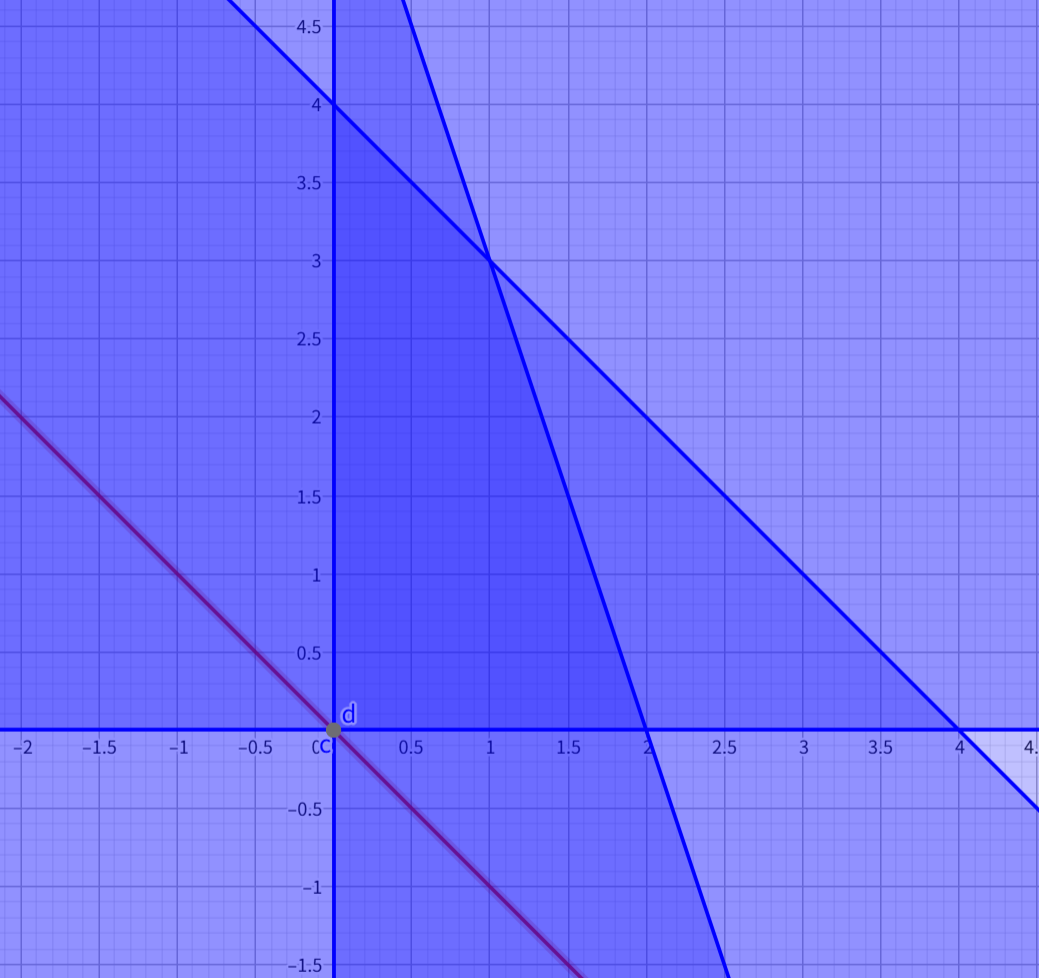
图中颜色最深的那个就是约束所围成的区域,也就是我们的可行域,此时称为单纯形。
图中红色的是目标函数等于0时候的直线。
那么什么时候目标函数能取最大呢?就是在这里:
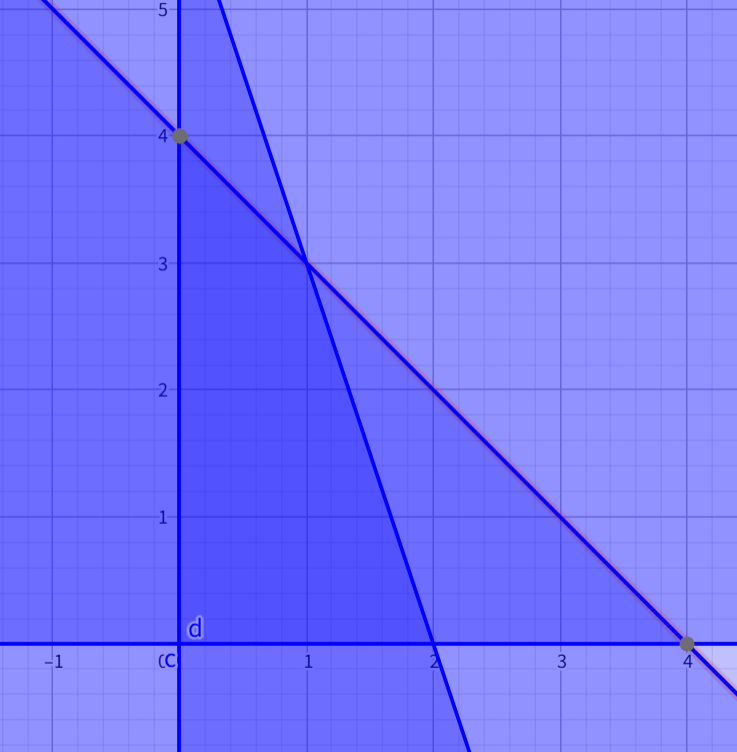
即往$-x-y=0$的法线平移,能够平移到单纯形最边上时,就是$-x-y$的最大值。
而单纯形总是凸的,并且目标函数总是线性的,这意味着最大值总是落在单纯形的顶点上。
同时这个例子中,目标函数的解是无穷多个的(因为目标函数所在直线和单纯形某条边重合了)。
那么我们要怎么找到这个顶点呢?简单来说,通过“爬山法”,每次都找能够让目标函数增长最大的路径即可:
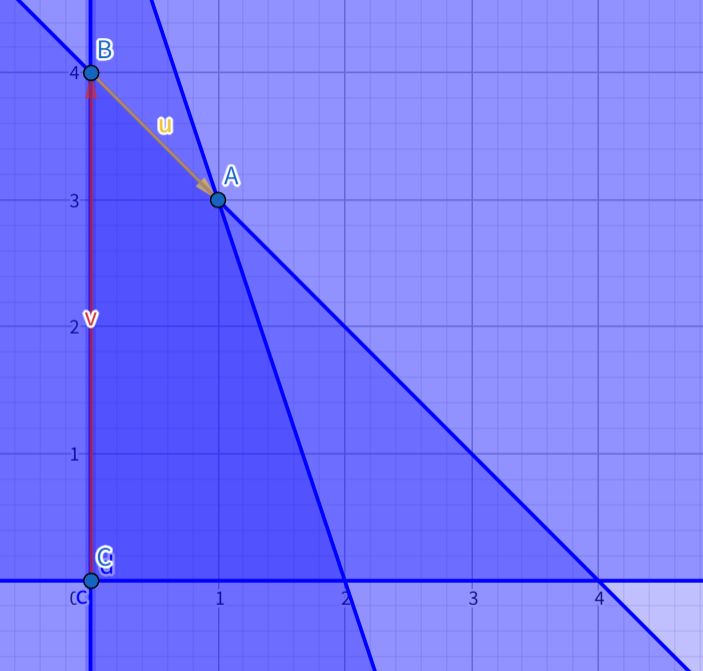
坐标先沿着路径$\vec{v}$再沿着路径$\vec{u}$就可以找到最大点。
接下来说这个步骤到底要怎么操作。
松弛变量和基本可行解#
首先引入松弛变量$s_i$,将不等式约束变成等式约束:
$$ \begin{aligned} & \text{maximize} && -x_1 - x_2 \\ & \text{subject to} && x_1 + x_2 + s_1 = 4\\ & && 3x_1 + x_2 + s_2 = 6 \\ & && x_1 + s_3 = 0 \\ & && x_2 + s_4 = 0 \\ \end{aligned} $$这样,问题中原有的变量$x_1, x_2$叫做“非基变量(non-basis variable)“,而松弛变量则是”基变量“。
后面使用$x_N$表示非基变量,用$x_B$表示基变量。
所有等式约束构成
接下来定义基本可行解(Basic Feasible Solution - BFS):
首先,所有的等式约束构成一个方程组,对应的矩阵为:
$$ Ax = b $$从$A$中选取$m$个线性无关的列(在本例中就是所有的列),构成矩阵:
$$ B = \begin{bmatrix} A_{j1} & \cdots & A_{jm} \end{bmatrix} $$这里$B$矩阵称为基。
令非基变量为0:
$$ x_N = 0 $$从而解出基变量:
$$ Bx_B = b \Rightarrow x_B = B^{-1}b $$如果$x_B \ge 0$,那么$x = (x_B, 0)$就是一个基本可行解。
如果某些基变量解出来为0,则称为退化。
之所以要定义基本可行解,是因为如下定理:
$x$是单纯形的顶点,当且仅当他是某个基的基本可行解
这就是为什么他叫基本可行解,他是满足所有约束的可行解,但不一定是最优的那个。
将基本可行解代入目标函数即可得到对应的目标值。
最优性定理(何时基本可行解最优)#
将变量分成基变量和非基变量(注意,这一步中不一定$x_i$是非基变量,而$s_i$是基变量。因为后面会介绍一个换基的操作,会将某些基变量变成非基变量。一般这一步是在算法迭代的某一步中最开始做的),以及其对应的矩阵$B$和$N$:
$$ A = \begin{bmatrix} B & N \end{bmatrix} \\ x = \begin{bmatrix} x_B \\ x_N \end{bmatrix} $$这样等式约束变成:
$$ Bx_B + Nx_B = b \Rightarrow x_B = B^{-1}b - B^{-1}Nx_N $$而目标函数(我们记为$c^T x$,此时通过后面将要介绍的某些操作,导致他里面含有基变量)也一样拆成基和非基变量的系数:
$$ \begin{aligned} c^Tx &= \begin{bmatrix} c_B \\ c_N \end{bmatrix}x \\ c^Tx & = c_B^Tx_B + c_N^Tx_N \\ & = c_B^TB^{-1}b + (c_N^T - c_B^TB^{-1}N)x_N \end{aligned} $$这里利用了上面推导出的$x_B$的式子。
那么可以定义 检验数(reduced costs) 矩阵:
$$ \bar{c}_N^T = c_N^T - c_B^TB^{-1}N $$那么$c^Tx$就变成:
$$ c^Tx = c_B^TB^{-1}b + \bar{c}_N^T x_N $$那么,如果当前算得基本可行解,这就意味着$x_N = 0$,那么
$$ c^Tx = c_B^TB^{-1}b $$就是此基本可行解的目标值。
那么,何时目标值最大呢?根据最优性检验定理:
如果
$$ \bar{c}_N \ge 0 $$那么对于任意的可行解$x_N \ge 0$,
$$ c^Tx = c_B^TB^{-1}b + \bar{c}_N^T x_N \ge c_B^TB^{-1}b $$那么当前基本可行解就是最优的。
注意:前面算目标值时是刻意令$x_N = 0$,这样才能反解出基本可行解。但是后面判断最优性时并没有强制$x_N = 0$。这是两个步骤。
现在我们知道如何判断一个基本可行解何时是最优的。那么接下来的问题就是,怎么找到这个基本可行解。
入基和出基变换#
在算法的最开始,所有的非基变量都是0(因为我们强制$x_N = 0$从而得到了当前的基本可行解)。
如果存在某个非基变量$x_{Ni}$,使得检验数大于0:
$$ \bar{c}_{Ni}^T \gt 0 $$那么就说明此变量可以让整体的目标值增大。那么我们当然可以让$x_{N_i}$从当前值开始增大,直到他到达某个上限。
这一步用人话说,就是选定一个方向($x_{Ni}$),然后不停往那个方向走,直到走到单纯形边界。
这里要 选择最大的$\bar{c}_{Ni}^T$,因为我们希望走过去的方向是最陡峭的。或者从数学上来说,目标函数对$x_{Ni}$的导数要是最大。这是因为,目标函数使用检验数表示为:
$$ \begin{aligned} c^Tx & = c_B^TB^{-1}b + \bar{c}_N^T x_N \\ & = c_0 + \sum r_i x_{Ni} \\ &\Rightarrow \\ c & = c_0 + \sum r_i x_{Ni} \\ \end{aligned} $$这里将左式视为$c$,右边第一项视为$c_0$,而后面的矩阵和向量乘积展开成求和。
这样,$\frac{\partial c}{\partial x_{Ni}} = r_i$,就是校验数。
这个时候,$x_{Ni}$就进基,将他变成基变量。
好,现在增大$x_{Ni}$,固定其他的非基变量为0,这样基变量就变成(套用前面的基变量公式):
$$ \begin{aligned} & x_B(\theta) = B^{-1}b - \theta B^{-1}N_i,& x_i = \theta \end{aligned} $$这里$\theta$是他走了多远。为了保证$x_B(\theta) \ge 0$,需要:
$$ \theta \le \min_{j: (B^{-1}N_i)_j > 0} \frac{(B^{-1}b)_j}{(B^{-1}N_i)_j} $$这样可以找到对应的$j$,而$j$对应的变量就得出基,把他变成非基变量。
这里可能公式有点乱,首先基变量公式是:
$$ x_B = B^{-1}b - B^{-1}Nx_N $$但是这里$x_{Ni} = \theta$,而其他所有$x_{Nj}$都是0。这样$Nx_N$就只能留下第$i$列(记为$N_i$)。
然后为了保证$x_B(\theta)$向量的各分量都$\ge0$,我要在$B^{-1}N_i$这个列向量中找到其中的某个正分量,这个分量满足后面$\frac{(B^{-1}b)_j}{(B^{-1}N_i)_j}$中最小的那个。这个分量就是$\theta$。
从几何上来说:
- BFS:是单纯形的一个顶点
- 进基变量:选择一条从当前顶点出发的边
- 方向$B^{-1}A_i$:沿着走的方向
- $\theta$:走多远
- 出基变量:在下个顶点处变成0的那个变量。这等于是松开一个本来起作用的约束,让他可能从0开始出发。
这里我觉得有必要以几何的视角阐述一下这些操作:
使用下面这个例子(你问我为什么不使用最开始的例子,因为我发现那个例子是退化的BFS,而我懒得改了):
$$ \begin{aligned} & \text{maximize} && z= 3x_1 + 5x_2 \\ & \text{subject to} && x_1 \le 4\\ & && 2x_2 \le 12 \\ & && 3x_1 + 2x_2 \le 18 \\ & && x_1, x_2 \ge 0 \\ \end{aligned} $$先把图画出来:
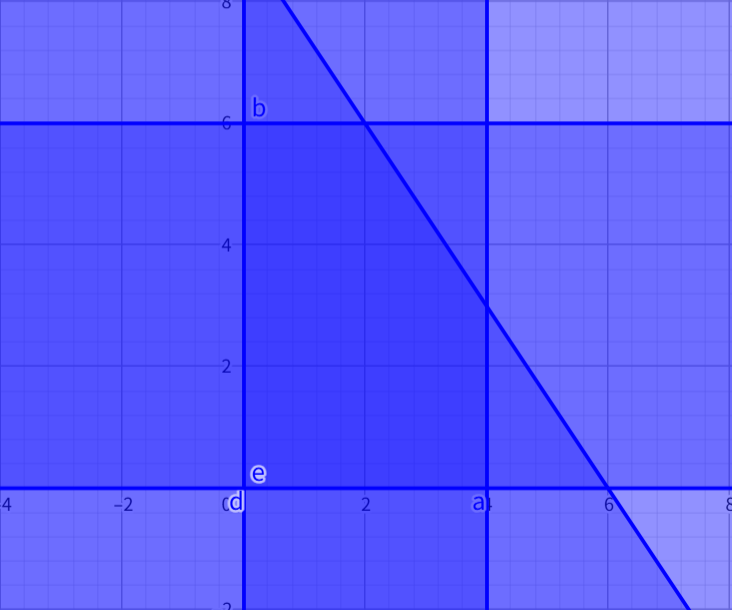
补上松弛变量,然后将目标函数也为等式(这里$z$显然是目标值):
$$ \begin{aligned} & \text{maximize} && z - 3x_1 - 5x_2 = 0 \\ & \text{subject to} && x_1 + s_1 = 4\\ & && 2x_2 + s_2 = 12 \\ & && 3x_1 + 2x_2 + s_3 = 18 \\ & && x_1, x_2, s_1, s_2, s_3 \ge 0 \\ \end{aligned} $$这里以单纯形表(Simplex Tableau)的方式(就是将上述操作变成表,以直观地看到每步的操作)展现。在问题最开始,表为:
| $z$ | $x_1$ | $x_2$ | $s_1$ | $s_2$ | $s_3$ | $b$ | |||
|---|---|---|---|---|---|---|---|---|---|
| $z$ | 1 | -3 | -5 | 0 | 0 | 0 | 0 | 基变量 | BFS中的值 |
| 约束1系数 | 0 | 1 | 0 | 1 | 0 | 0 | 4 | $s_1$ | 4 |
| 约束2系数 | 0 | 0 | 2 | 0 | 1 | 0 | 12 | $s_2$ | 12 |
| 约束3系数 | 0 | 3 | 2 | 0 | 0 | 1 | 18 | $s_3$ | 18 |
| $\bar{c}_N^T$ | 3 | 5 | 0 | 0 | 0 |
这本质上是两个表:目标函数和约束函数的系数,以及等式右边$b$那一列构成一个表。然后是基变量和基变量在当前BFS中的值构成一个表。只是我们操作时要同时对两个表进行操作,所以将他们并在一起。
然后注意检验数的计算,其每一个元素对应:
$$ \bar{c}_{Ni}^T = c_{Ni}^T $$这里利用$c_B^T$为0矩阵,$B^{-1}$为单位矩阵,然后展开每一个元素的公式。这样,初始的校验数就是对应非基变量在$z= 3x_1 + 5x_2$中的系数。或者你就直接记是z所在行对应非基变量的相反数。
初始时,基变量显然是:
$$ x_B = \begin{bmatrix} s_1 \\ s_2 \\ s_3 \\ \end{bmatrix} = \begin{bmatrix} 4 \\ 12\\ 8 \\ \end{bmatrix} $$而非基变量我们强制为0:
$$ x_N = \begin{bmatrix} x_1 \\ x_2 \\ \end{bmatrix} = \begin{bmatrix} 0 \\ 0 \\ \end{bmatrix} $$那么初始BFS就是:
$$ (x_1, x_2, s_1, s_2, s_3) = (0, 0, 4, 12, 18) $$而由于我们令非基变量为0,所以当前目标值是0。
接下来,我要找到$\bar{c}_{Ni}^T$中最大的那个。这里是$\bar{c}_{N2}^T = 5$。
其实本质上是找目标函数对应法线的最大分量:
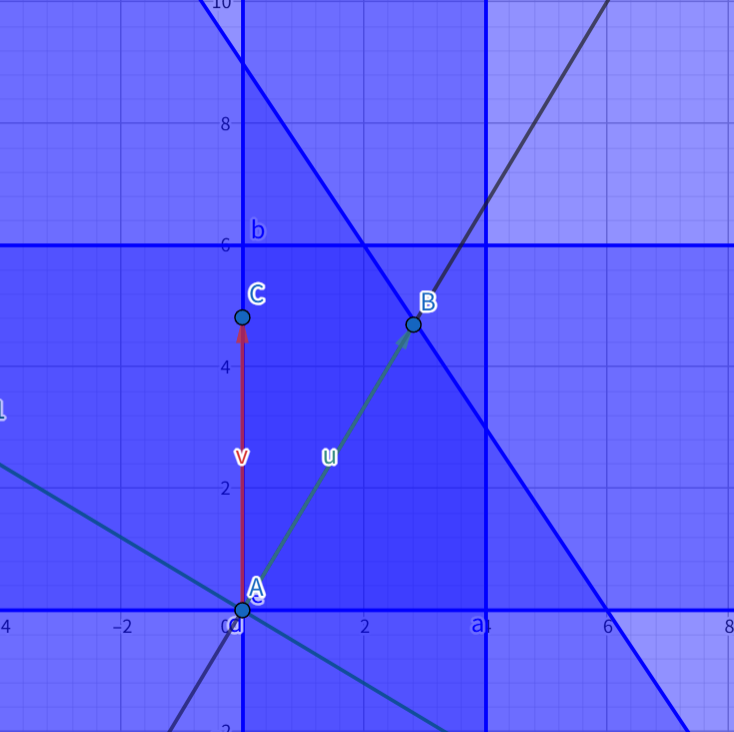
这里如果以$x_1$为横坐标,$y_1$为纵坐标,那么绿色就是目标函数法向量。而红色就是最大的分量(5)。
所以我们要沿着最大分量走,因为这是最“陡峭”(或者说最贪)的方向。或者严格来说,现在行走的方向是$d = B^{-1}N_i$。在这里就是$(0, 5)$。
接下来就是看要走多远。上面说判定的方法是:
$$ \theta \le \min_{j: (B^{-1}N_i)_j > 0} \frac{(B^{-1}b)_j}{(B^{-1}N_i)_j} $$此时,由于$B^{-1}$是单位矩阵,所以我们只要在$N_i$中找到最小的那个正分量对应的下标。此刻$i=2$,那么就是看$x_2$那一列中,三个约束那三行中哪个值能让$\frac{(B^{-1}b)_j}{(B^{-1}N_i)_j}$最小。这里三个值分别是$(NaN, 6, 9)$(注意,第一行$x_2$的约束1系数为0,不在考虑范围内)。那么选最小的那个,于是$j = 2$。
那么就是往$x_2$方向,走长度为6。这样就走到顶点了。
由于对应第二行,而第二行的基变量是$s_2$,所以$s_2$出基,而$x_2$入基。这一步叫基交换。
那么这个时候,第二个约束所对应的基变量就从$s_2$变成$x_2$了:
| $z$ | $x_1$ | $x_2$ | $s_1$ | $s_2$ | $s_3$ | $b$ | |||
|---|---|---|---|---|---|---|---|---|---|
| $z$ | 1 | -3 | -5 | 0 | 0 | 0 | 0 | 基变量 | BFS中的值 |
| 约束1系数 | 0 | 1 | 0 | 1 | 0 | 0 | 4 | $s_1$ | 4 |
| 约束2系数 | 0 | 0 | 2 | 0 | 1 | 0 | 12 | $x_2$ | 12 |
| 约束3系数 | 0 | 3 | 2 | 0 | 0 | 1 | 18 | $s_3$ | 18 |
| $\bar{c}_N^T$ | 3 | 5 | 0 | 0 | 0 | ||||
| 注意表中$s_2$和$x_2$的位置。但是其他的数值先别看,因为还要做一步主元法让数值正确。 |
那么这个时候就又有问题:
- 为什么$\theta$要取其中最小的?
这是因为,如果取大了,那么有可能走到单纯形外面(导致某个不等式约束左边$\ge 0$了)。所以必须取最小的来保证走完后所有不等式约束都满足。
主元变换#
选好进基变量和出基变量之后,以它们的交点为主元,对单纯形表做行变换,使进基变量那一列变成单位向量。
本质上是做一次高斯消元,只是对主元做。
主元是出基和入基变量所在行列的交点。
在进行基交换之前,看$x_2$所在列和$s_2$所在行的交点:
| $z$ | $x_1$ | $x_2$ | $s_1$ | $s_2$ | $s_3$ | $b$ | |||
|---|---|---|---|---|---|---|---|---|---|
| $z$ | 1 | -3 | -5 | 0 | 0 | 0 | 0 | 基变量 | BFS中的值 |
| 约束1系数 | 0 | 1 | 0 | 1 | 0 | 0 | 4 | $s_1$ | 4 |
| 约束2系数 | 0 | 0 | 2 | 0 | 1 | 0 | 12 | $x_2$ | 12 |
| 约束3系数 | 0 | 3 | 2 | 0 | 0 | 1 | 18 | $s_3$ | 18 |
| $\bar{c}_N^T$ | 3 | 5 | 0 | 0 | 0 | ||||
| 这里这个$2$就是主元。 |
主元变换是指如下操作:
- 主元行归一化:将主元所在行除以主元。这样表格就变成:
| $z$ | $x_1$ | $x_2$ | $s_1$ | $s_2$ | $s_3$ | $b$ | |||
|---|---|---|---|---|---|---|---|---|---|
| $z$ | 1 | -3 | -5 | 0 | 0 | 0 | 0 | 基变量 | BFS中的值 |
| 约束1系数 | 0 | 1 | 0 | 1 | 0 | 0 | 4 | $s_1$ | 4 |
| 约束2系数 | 0 | 0 | 1 | 0 | $\frac{1}{2}$ | 0 | 6 | $x_2$ | 6 |
| 约束3系数 | 0 | 3 | 2 | 0 | 0 | 1 | 18 | $s_3$ | 18 |
| $\bar{c}_N^T$ | 3 | 5 | 0 | 0 | 0 | ||||
| 2. 消去主元列的其他元素:就是做一次高斯消元法: |
| $z$ | $x_1$ | $x_2$ | $s_1$ | $s_2$ | $s_3$ | $b$ | |||
|---|---|---|---|---|---|---|---|---|---|
| $z$ | 1 | -3 | 0 | 0 | $\frac{5}{2}$ | 0 | 0 | 基变量 | BFS中的值 |
| 约束1系数 | 0 | 1 | 0 | 1 | 0 | 0 | 4 | $s_1$ | 4 |
| 约束2系数 | 0 | 0 | 1 | 0 | $\frac{1}{2}$ | 0 | 6 | $x_2$ | 6 |
| 约束3系数 | 0 | 3 | 0 | 0 | -1 | 1 | 18 | $s_3$ | 6 |
| $\bar{c}_N^T$ | 3 | 5 | 0 | 0 | 0 | ||||
| 注意:$\bar{c}_N^T$行不做。 |
这样主元变换就做完了。
这样,新的基就是$x_B = \{s_1, x_2, s_3\}$,而新的$B$就是$\{s_1, x_2, s_3\}$在表格中的列构成的$3\times 3$矩阵(只看约束系数)。然后要令新的非基变量$\{x_1, s_2\}$是0,所以新的BFS就是$(x_1, x_2,s_1, s_2, s_3) = (0, 6, 4, 0, 6)$。
主元变换完毕后,要更新检验数。而很“凑巧”的是,$B$矩阵依旧是单位矩阵,所以我们还是看$z$所在列非基变量的相反数。这里新的$\bar{c}_N^T = (3, 0, 0, -\frac{5}{2}, 0)$,表格变成:
| $z$ | $x_1$ | $x_2$ | $s_1$ | $s_2$ | $s_3$ | $b$ | |||
|---|---|---|---|---|---|---|---|---|---|
| $z$ | 1 | -3 | 0 | 0 | $\frac{5}{2}$ | 0 | 0 | 基变量 | BFS中的值 |
| 约束1系数 | 0 | 1 | 0 | 1 | 0 | 0 | 4 | $s_1$ | 4 |
| 约束2系数 | 0 | 0 | 1 | 0 | $\frac{1}{2}$ | 0 | 6 | $x_2$ | 6 |
| 约束3系数 | 0 | 3 | 0 | 0 | -1 | 1 | 18 | $s_3$ | 6 |
| $\bar{c}_N^T$ | 3 | 0 | 0 | $-\frac{5}{2}$ | 0 |
那么主元变换的步骤就介绍完毕了。但问题是:为什么要这样做?
主元变换本质上是构造一个新的基,新基是基于当前走到的顶点的。
其实$(x_1, x_2)$就是我们当前的坐标。最开始令他两为0,这意味着我们从原点开始走。
现在走了一步后,$(x_1, x_2) = (0, 6)$,正是我们走到的顶点:
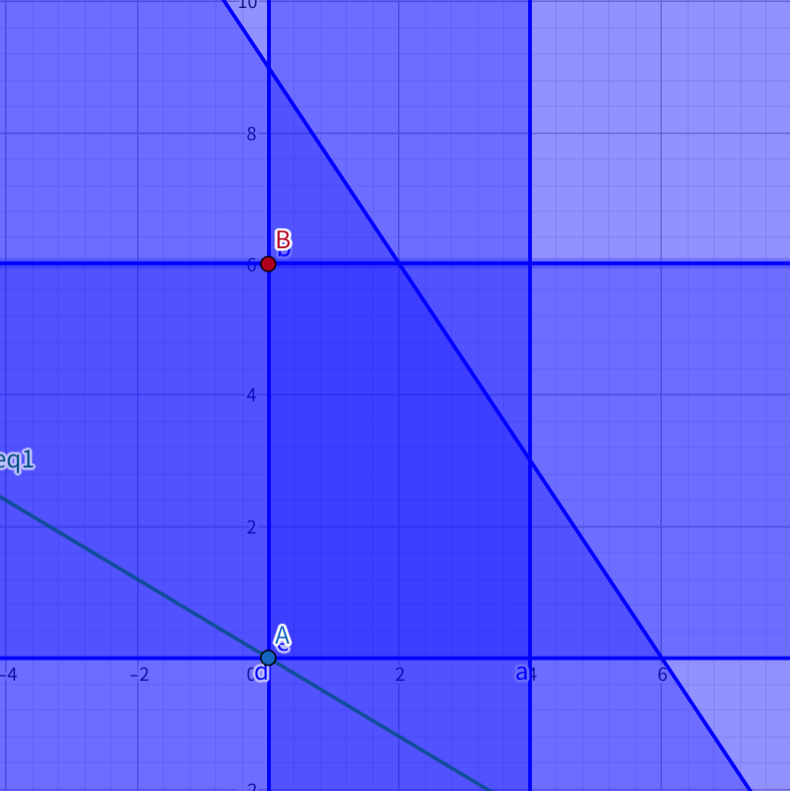
也就是$B$点。
而$s_1, s_2, s_3$三个松弛变量,则是表示当前点离他们所在的约束边有多远(只是一种度量,不是欧式距离,但是可以转化成欧氏距离)。
以$s_2$为例,其约束为:
$$ 3x_1 + 2x_2 + s_2 = 18 \Rightarrow s_2 = 18 - 3x_1 - 2x_2 $$我们知道原点到直线的距离公式是:
$$ d = \frac{|Ax + By + C|}{\sqrt{A^2 + B^2}} $$而其中分母正好是$s_2$。
所以真正的距离是$\frac{s_2}{\sqrt{(-3)^2 + (-2)^2}}|_{(0, 0)} = \frac{18}{\sqrt{(-3)^2+(-2)^2}}$。
而当我们走一步之后,这个度量仍然没变,整个公式中只有$(x_1, x_2)$变化了。
这就是为什么$s_2 = 0$,因为他已经在第二个约束上了,度量为0。
对于“基变量”和“非基变量”的几何理解:
“非基变量”所在的约束,就是现在你已经到达约束边界的约束(顶着你的墙)。比如最开始非基变量是$x_1, x_2$。此时你在原点,刚好顶着他们两个($x_1 \ge 0, x_2 \ge 0$)。
走了一步之后,非基变量是$x_1, s_2$。刚好是$x_1 \ge 0, 2x_2 \le 12$这两条边顶着你。
而“基变量”就是离你还有距离的变量。这也解释了为什么要换基。因为你每次走完顶着你的边都不一样了,换基就等于是换顶着你的边。然后找走向新基变量(没顶着你的边)的方向和大小。这样才能在单纯形的边上游走。
而主元变换不产生新信息(移动点的是换基),他只是将同一个方程组换一组变量来解。你可以看到主元变换的操作都是不改变原方程组解的操作。
而主元法做的两步其实是在做一个事情:将新的非基变量所在列变成$\begin{bmatrix} \vdots \\ 0 \\ \vdots \\ 1 \\ \vdots \\0 \\\vdots \end{bmatrix}$ 的形式。即只有出基变量那一行是1,其他都是0。这是为了满足“将基变量全部视为0”的那个条件。而之所以留个1,是为了让新的$B$构成单位矩阵。这样就不用解$B^{-1}$了。
例子中最后走一步#
那么在走到$B$点之后我们可以进行下一步了。
首先还是看$\bar{c}_N^T$中最小的正值。显然这里是3,那么就选$i = 1$即$x_1$作为新的入基。
然后找距离。这里可以找到$j = 3$时$\theta = 2$是最小的。所以出基是$s_3$。
那么,我们就沿着$x_1$方向移动2。刚好移动到顶点:
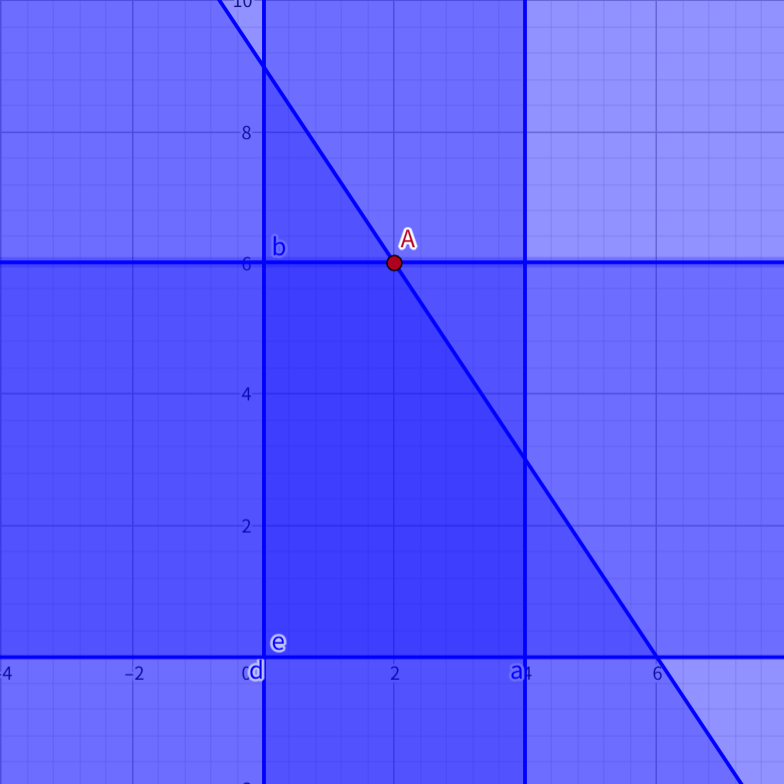
此时,经过主元变换后的表格为:
| $z$ | $x_1$ | $x_2$ | $s_1$ | $s_2$ | $s_3$ | $b$ | |||
|---|---|---|---|---|---|---|---|---|---|
| $z$ | 1 | 0 | 0 | 0 | $\frac{3}{2}$ | 1 | 36 | 基变量 | BFS中的值 |
| 约束1系数 | 0 | 0 | 0 | 1 | $\frac{1}{3}$ | $-\frac{1}{3}$ | 2 | $s_1$ | 2 |
| 约束2系数 | 0 | 0 | 1 | 0 | $\frac{1}{2}$ | 0 | 6 | $x_2$ | 6 |
| 约束3系数 | 0 | 1 | 0 | 0 | $-\frac{1}{3}$ | $\frac{1}{3}$ | 2 | $x_1$ | 2 |
| $\bar{c}_N^T$ | 0 | 0 | 0 | $-\frac{3}{2}$ | -1 |
接下来继续算法,找最小的正校验数。你会发现没有。这说明我们已经到达最优点,算法结束。此时最优点是$(2, 6)$。
单纯形法的终止条件#
对于最大化问题来说,只要$\bar{c}_N^T$中所有元素都为负数,就找到了最大值(如果是最小化问题,则要求所有元素都为正)。
对于最大化问题来说,如果找$\theta$时发现$N_i$的所有分量都小于0,那么单纯形无界(不闭合),原问题无界,最优目标值为$+\infty$。
Dantzig规则和Bland规则#
在选入基和出基时有两条规则:
- Dantzig规则:即上面说的规则。简单来说就是选最陡的方向。他比较快。
- Bland规则:
- 入基:在所有$\bar{c}_N^T \gt 0$的变量中,选下标最小的
- 出基:比值检验并列的基向量中,选下标最小的 所以Bland规则又叫双重最小下标规则。比Dantzig慢,但可以防止循环。
Bland规则主要是防止循环,保证单纯形法能在有限步骤内终止。
何时单纯形法会死循环?答案是退化时:
- BFS退化:至少有一个基变量为0
- 退化时,最小比值可能$\theta = 0$,这意味着点根本不移动。
- 换基后,点没变,目标值没变,只是换了一组基。这时会无限换基
- 主元规则可能不好,在一组基之间绕圈,最后又回到原点,无限循环
但是退化不一定循环。但是循环一定是退化了。
一个经典的用Dantzig法导致循环的例子是Beale的例子:
$$ \begin{aligned} &\text{maximize} && z=\frac34x_1-150x_2+\frac1{50}x_3-6x_4\\ &\text{subject to} && \frac14x_1-60x_2-\frac1{25}x_3+9x_4\le 0\\ & && \frac12x_1-90x_2-\frac1{50}x_3+3x_4\le 0\\ & && x_3\le 1\\ & && x_1,x_2,x_3,x_4\ge 0 \end{aligned} $$可以自己去试一下。
参考#
- Michel Goemans(MIT 18.310)Linear Programming 讲义
- Numerical Methods for Linear Complementarity Problems in Physics-based Animation