本文记录了LCP问题相关知识。需要先了解最优化理论。
NOTE:此文章可能在未来我看完整个Pivoting Method之后挪到专门的Pivoting Method文章中(Lemke , Dantzig, Simplex三个方法)。
LCP为线性互补问题(Linear Complementarity Problem)。
一维LCP#
一维线性互补问题为:有两个变量$x, y \in \mathbb{R}$,并且满足互补性约束:
$$ y > 0 \Rightarrow x = 0 \text{ 或 } x > 0 \Rightarrow y = 0 $$用符号记作
$$ 0 \le y \perp x \ge 0 $$这个条件其实就是互补松弛。
这个问题也可以写成:
$$ \begin{aligned} y & \ge 0 \\ x & \ge 0 \\ xy & = 0 \\ \end{aligned} $$如果将问题扩展为$y$和$x$之间的线性关系$y = ax+b$,那么LCP问题变成:
$$ \begin{aligned} y & = ax+b \\ y & \ge 0 \\ x & \ge 0 \\ xy & = 0 \\ \end{aligned} $$这里可以消去$y$变成:
$$ \begin{aligned} ax+b & \ge 0 \\ x & \ge 0 \\ x(ax+b) & = 0 \\ \end{aligned} $$注意到,$x(ax+b) = 0$是二次函数,而其相乘的两个分量都必须大于等于0。这意味着任意可行的$x$都会让二次函数取非负值。二次函数只有在LCP的解处才为0。也就是说,此时LCP是一个凸优化问题(严格来说是个二次规划(QP)问题):
$$ \begin{aligned} & \text{minimize} && x(ax+b) \\ &\text{subject to} && x \ge 0 \\ & && ax+b \ge 0 \\ \end{aligned} $$但我们稍后就会看到,在更高维度下LCP不一定是凸优化问题。
那么现在可以来解此凸优化问题吗?可以,但实践上发现不好解。我们可以逆用KKT条件来构造出一个全新的优化问题:
$$ \begin{aligned} & \text{minimize} && f(x) = \frac{1}{2}ax^2 + bx \\ & \text{subject to} && x \ge 0 \end{aligned} $$那么,此优化问题的拉格朗日函数就是(将不等式条件变成$-x \le 0$,然后用$y$代替$\lambda$(只是将$\lambda$名称换成$y$,毕竟本问题中无$y$变量)):
$$ L(x, y) = f(x) - xy $$这个问题的KKT条件是:
$$ \begin{aligned} \nabla_x L(x, y) & = 0 \\ y & \ge 0 \\ x & \ge 0 \\ yx & = 0 \\ \end{aligned} $$之所以要这样构造,是因为$\nabla_xL(x, y) = 0 \Rightarrow ax + b - y = 0 \Rightarrow y = ax + b$,然后将$y$代回上面的KKT条件就又回到LCP问题了。也就是说这个KKT条件的解和LCP问题的解是等价的。
虽然LCP问题并不等同于一个优化问题。但此优化问题的所有一阶最优解都是LCP的解(反之亦然)。
高维LCP#
接下来将LCP推广到高维:
令$b, x \in \mathbb{R}^n$,$A \in \mathbb{R}^{n \times n}$,于是$y = Ax + b$,那么LCP问题就是:
$$ \begin{aligned} & y = Ax + b \\ & x \ge 0 \\ & y \ge 0 \\ & x^Ty = 0 \\ \end{aligned} $$而其本身是如下KKT条件的解:
$$ \begin{aligned} \nabla_x(\frac{1}{2}x^TAx + b^T x) & = 0 \\ x & \succeq 0 \\ y & \succeq 0 \\ x^Ty & = 0 \\ \end{aligned} $$那么,如果$A$是对称的,这个问题就可以用凸优化那套方法去解。
可以看到,LCP就是在LP问题上增加了互补条件$x^Ty = 0$。
LCP求解#
接下来提出求解LCP的方法。他们每个都有不同的优缺点和条件。
当LCP的解和凸优化的解一致时,可以用任意的凸优化方法去解LCP问题(本质解对应凸优化问题)。
枚举法#
由于存在互补规则,即至少有一个变量为0,所以LCP的解就分为三类:
- $x_i$全为0
- $y_i$全为0
- 某些$x_i$和$y_j$为0
这样我就可以使用枚举法,枚举所有可能的$x_i = 0$和$y_i = 0$的组合来找到正确的解。
具体的做法是,假设$x$和$y$各有$n$个,选择向量$(x_1, \cdots, x_m, y_1, \cdots, y_r) = 0, m+r = n, m \ge 0, r \ge 0$,此向量满足互补条件。这样剩下的变量就构成一个方程组。我们通过解方程组将剩下的变量全部解出来,看他们满不满足剩下的$x \ge 0, y \ge 0$的约束。如果满足,我们就找到了解。
理解枚举法是理解主元法的前提,所以这里说的详细一点。这里我们可以使用一个例子:
$$ \begin{aligned} A &= \begin{bmatrix} 2 & 1\\ 1 & 3\\ \end{bmatrix} \\ b &= \begin{bmatrix} -4 \\ -9 \end{bmatrix} \\ \end{aligned} $$这里一共有$y_1, y_2, x_1, x_2$四个变量。那么可能的解一共就有4种,我们看其中的一种:
$(y_1, y_2) = 0$:方程就变为:
$$ \begin{aligned} 2x_1 + x_2 - 4 &= 0 \\ x_1 + 3x_2 -9 &= 0 \\ \end{aligned} $$那么解这个方程组,使用一次高斯消元法(比如将一式减去二式乘2),得到:
$$ \begin{aligned} -5x_2 + 14 &= 0 \Rightarrow x_2 = 2.8 \end{aligned} $$然后再反解出$x_1 = 0.6$
这时发现$x_1 > 0, x_2 > 0$,所以这就是LCP问题的解
其他的三个如法炮制,会发现解出的变量总是有小于0的,所以构不成解。
主元法(Pivoting Method)#
主元法利用LCP的组合性质,通过勾勒出一种“猜测”式的求解途径,以尽可能减少枚举的数目。
主元法总是能够找到准确解,或者报告无解。
Dantzig在他的文章《Complementary pivot theory of mathematical programming》中详细说明了主元法,并且将单纯形法,LCP主元法融入了同一个框架(就叫主元法),并说明了单纯形法是主元法的特例。但是那是数学上的操作,几何上他两其实不太相关,所以我的建议是不要试图从单纯形法中直观地理解主元法,这里还是和单纯形法分开,但是你确实会再次看到很多单纯形法中的定义和操作。
Lemke方法#
由Lemke提出的,可以得到精确解(或无解)的方法。他通过构造一个总是满足约束的新问题$y = Ax + b + dx_0$,通过想办法让$x_0 = 0$来让问题回到原问题,以此让这两个问题的解相等来间接求出原问题。
步骤#
Lemke主元法的思路是:强制地让所有$x_i$为0,这样就有
$$ y = b $$但是$b$不一定所有元素都是正的,所以Lemke为了让这个条件可达,他强制加一个$dy_0$在末尾:
$$ y = b + dx_0 \ge 0 $$这里$d$是一个大于0的列向量(称为覆盖向量),$x_0$是一个大于0的数(称为人工变量)。理论上是可以随意取,但实现上$d$一般就取一个全1向量,那么我们可以取$b_i$中最小的数的相反数,这样就可以让$y$中所有元素都大于等于0了。即:
$$ x_0 = -\min_i b_i $$或者在$d$不是全一向量下:
$$ x_0 = \max_i -\frac{b_i}{d_i} $$这时,Lemke构造了一个新的互补问题:$y = Ax + b + dy_0$。这个问题的解就是$x = 0$。只有当$y_0 = 0$时才变回原来的问题。
我们将强制置为0的变量称为非基变量,而剩下的变量就是基变量。
非基变量和基变量不是永远不变的,后面会看到有基交换操作会改变他们。这里的核心点是非基变量总是0。而基变量总不是0(除非在算法刚开始,因为一定有至少一个$y_i = 0$,或者在算法过程中发生退化)。
那么我们的目标就是要想办法让$x_0 = 0$,这样在这个新问题上找到的解就是原问题的解。
这时,每对$(x_i, y_i)$都构成一对互补变量。即其中有一个基变量,一个非基变量。互补变量满足互补条件。
注意此时人工变量$x_0$既不是基变量也不是非基变量。
这时,至少有一个$y_i = 0$。理想情况下是只有一个$y_i = 0$,如果有多个,称起点额外退化,此时得按规则在这些等于0的$y_i$中挑一个。我们假设最后定下的是$y_r$
然后用所有的非基变量表示基变量。这里我们做一般化,记$x_N$为非基变量构成的列向量,$x_B$为基变量构成的列向量,将原问题写成矩阵形式:
$$ A = \begin{bmatrix} B & N \end{bmatrix} \\ x = \begin{bmatrix} x_B \\ x_N \end{bmatrix} $$比如在问题:
$$ \begin{aligned} A &= \begin{bmatrix} 2 & 1\\ 1 & 3\\ \end{bmatrix} \\ b &= \begin{bmatrix} -4 \\ -9 \end{bmatrix} \\ \end{aligned} $$中,假设基变量是$y_1, y_2$,非基变量是$x_1, x_2$,那么就有:
$$ \begin{aligned} B &= \begin{bmatrix} 1 & 0 \\ 0 & 1 \\ \end{bmatrix} \\ N & = \begin{bmatrix} -2 & -1 \\ -1 & -3 \\ \end{bmatrix} \\ x_B &= \begin{bmatrix} y_1 \\ y_2 \\ \end{bmatrix} \\ x_N &= \begin{bmatrix} x_1 \\ x_2 \\ \end{bmatrix} \\ b &= \begin{bmatrix} -4 \\ -9 \\ \end{bmatrix} \\ \Rightarrow \\ & \begin{cases} y_1 - 2x_1 - x_2 & = -4 \\ y_2 - x_1 - 3x_2 & = -9 \\ \end{cases} \end{aligned} $$而如果你假设$x_1, y_2$是基变量,$x_2, y_1$是非基变量,那么通过对原方程组变形,可以得到:
$$ \begin{aligned} & \begin{cases} y_2 = \frac{1}{2}y_1 + \frac{5}{2}x_2 - 7 \\ x_1 = \frac{1}{2}y_1 - \frac{1}{2}x_2 + 2 \\ \end{cases} \\ \Rightarrow \\ B &= \begin{bmatrix} 1 & 0 \\ 0 & 1 \\ \end{bmatrix} \\ N & = \begin{bmatrix} \frac{1}{2} & \frac{5}{2} \\ \frac{1}{2} & -\frac{1}{2} \\ \end{bmatrix} \\ x_B &= \begin{bmatrix} y_1 \\ x_2 \\ \end{bmatrix} \\ x_N &= \begin{bmatrix} x_1 \\ y_2 \\ \end{bmatrix} \\ b &= \begin{bmatrix} -7 \\ -2 \\ \end{bmatrix} \\ \end{aligned} $$那么,我总能用$x_N$表示$x_B$,只需:
$$ \begin{aligned} & Bx_B + Nx_N = b \\ & \Rightarrow \\ & x_B = B^{-1}(b - Nx_N) = B^{-1}b - B^{-1}Nx_N \end{aligned} $$这里有个很讨厌的$B^{-1}$让我们每次都要求逆。但在后面的算法步骤中可以看到,每一步都会保证$B$为单位矩阵,这样就免去了求逆。
在Lemke算法的最开始,$B$总是单位矩阵。我们用一个表格来记录此时的信息:
| 基变量 | 基变量 | 非基变量 | 非基变量 | 非基变量 | |||
|---|---|---|---|---|---|---|---|
| $y_1$ | $y_2$ | $x_1$ | $x_2$ | $x_0$ | b | 基变量 | |
| 第1个方程组系数 | 1 | 0 | -2 | -1 | -1 | -4 | $y_1$ |
| 第2个方程组系数 | 0 | 1 | -1 | -3 | -1 | -9 | $y_2$ |
在加上$dx_0$之后,显然,$y_2$将会变成0。这时,我们做一个入基和出基的操作:
- 入基:将某个变量视为基变量
- 出基:将某个变量视为非基变量
此时,将$x_0$入基$y_2$出基。然后做一次主元变换:
主元是指入基变量所在列,和出基变量所在行的交叉部分。这里是$-1$。
主元变换则是做高斯消元,让主元所在列中,主元变量变为1,非主元变量全变为0。
我们可以显然昂主元变成1,然后用它去将其他列变成0:
- 第二行 = 第二行 * -1
- 第一行=第一行 + 第二行
然后将入基和出基的变量互换位置(字面意义上,只是在表格里换个位置)(这一步是基交换),这样新表格就是:
| 基变量 | 非基变量 | 非基变量 | 非基变量 | 基变量 | ||||
|---|---|---|---|---|---|---|---|---|
| $y_1$ | $y_2$ | $x_1$ | $x_2$ | $x_0$ | b | 基变量 | ||
| 第1个方程组系数 | 1 | -1 | -1 | 2 | 0 | 5 | $y_1$ | |
| 第2个方程组系数 | 0 | -1 | 1 | 3 | 1 | 9 | $x_0$ |
可以看到基变量对应的矩阵$B$仍旧为单位阵。
接下来得重复上述的入基,出基,主元变换。但这时,我们要选刚才出基的互补变量。
刚才出基的是$y_2$,他的互补变量是$x_2$,那么就让$x_2$入基。此时$x_2$叫驱动变量。
那么谁出基呢?这里要做一次比值检验,即看驱动变量那一列系数为正的元素所在行,然对应$b$值和对应元素做比,然后选最小的那个(这一步是比值检验)。
注:如果所有系数都为负,则原LCP问题无解。
这里$5 / 2 = 2.5$, $9 / 3 = 3$,那么选2.5所在那一行的基变量,是$y_1$。所以$y_1$出基。
那么做完这次主元变换后的表格是:
| 非基变量 | 非基变量 | 非基变量 | 基变量 | 基变量 | |||
|---|---|---|---|---|---|---|---|
| $y_1$ | $y_2$ | $x_1$ | $x_2$ | $x_0$ | b | 基变量 | |
| 第1个方程组系数 | 0.5 | -0.5 | -0.5 | 1 | 0 | 2.5 | $x_2$ |
| 第2个方程组系数 | -1.5 | 0.5 | 2.5 | 0 | 1 | 1.5 | $x_0$ |
| 注意洞总是传给最后出基的那个变量。 |
然后再做一次主元变换,这次是$x_0$出基,$x_1$入基。这样表格变成:
| 非基变量 | 非基变量 | 基变量 | 基变量 | 非基变量 | |||
|---|---|---|---|---|---|---|---|
| $y_1$ | $y_2$ | $x_1$ | $x_2$ | $x_0$ | b | 基变量 | |
| 第1个方程组系数 | 0.2 | -0.4 | 0 | 1 | 0.2 | 2.8 | $x_2$ |
| 第2个方程组系数 | -0.6 | 0.2 | 1 | 0 | 0.4 | 0.6 | $x_1$ |
| 这下$x_0$又被换出去了,也就是说此时$x_0 = 0$,当前的解就是原问题的解,非基变量取0,基变量取对应的$b$值。 |
也就是说原问题的解是$(y_1, y_2) = 0, (x_1, x_2) = (0.6, 2.8)$。
为何可行#
接下来解释算法为什么要这样做。
主元法的全称是“旋转主元法”(principal pivoting method),其中“主元”的意思是,将某些变量视为“主变量”(即函数中的因变量),将其他变量视为自变量。而“旋转”的意思是不停地更换主元。
这里“基变量”就是每次视为的主元。而每次入基/出基和主元变换就是在做“旋转”。
所以你可以看到,每次都要用非基变量取表示基变量,这样基变量才是因变量。具体来说是每次都要用高斯消元法将主元变成1,其列中其他元素变为0。这里有两个事情:
- 其他元素变为0:此主元变量(基变量)在其他基变量中系数为0,意味着他们之间是独立的
- 将自己的系数变为1:这样方程为$x_i + \sum c_j x_j = b_i, i \ne j$等价于$x_i = b_i - \sum c_j x_j$,也就是说将当前基变量视为主元(因变量)
上面两件事等价于将$B$变为单位矩阵。
诡异的是,算法当中真正改变了方程组本身值(我指$A$和$b$矩阵)的操作就只有主元变换中的高斯消元法。而众所周知,高斯消元法是不改变方程组本身的解的。
也就是说,问题$y = Ax + b + dx_0$本身总是成立的。而基变换本身并不改变任何方程中的值。所以无论怎么基变换,方程也总是成立。这个恒成立条件在算法中总是存在,所以不管怎么变换基,做主元变换都是对的。只有一点要注意:每次换后的非基变量必须和基变量形成互补变量,不然会违反互补条件。
这就是为什么每次基变换时总要找到出基的互补变量入基,这样能保证非基变量和基变量总是互补的,这样不会破坏互补条件。
也就是说,互补对中的一对变量在整个算法中是完全不变的。
而$x_0$是一个特殊的东西,他是一个“洞”。他没有互补变量。他的作用是替代一对互补对:
因为互补对要求其中一个是基变量,另一个是非基变量。而如果两个都是非基变量/基变量,那么$x_0$就必须去代替他们,不然互补条件会出错。
比如之前的例子中,最开始的互补情况是(基变量放最左边,中间是对应非基变量,游离变量放在最右边):
$$ \begin{aligned} \begin{bmatrix} y_1 \\ y_2 \\ \end{bmatrix} \begin{bmatrix} x_1 \\ x_2 \\ \end{bmatrix} x_0 \end{aligned} $$经过一次基交换后变成:
$$ \begin{aligned} \begin{bmatrix} y_1 \\ x_0 \\ \end{bmatrix} \begin{bmatrix} x_1 \\ \emptyset \\ \end{bmatrix} y_2, x_2 \end{aligned} $$再经过一次基交换后变成:
$$ \begin{aligned} \begin{bmatrix} x_2 \\ x_0 \\ \end{bmatrix} \begin{bmatrix} y_2 \\ \emptyset \\ \end{bmatrix} y_1, x_1 \end{aligned} $$可以看到,$x_0$只是起到一个占位作用。
这也就解释了为什么最开始要找一个$y_i = 0$进行基交换,因为他这个时候为0已经不是主元变量了。肯定要给他换出去。
在满足互补性下,我就需要不停地换非基变量(等价于换基变量)来看到底哪种非基变量的组合内包含$x_0$。而每次换非基变量只有唯一一种选择。
因为$x_0$是单调下降的。他总是从$>0$一直向0走。这个是“$A$是P-矩阵”这件事保证的在(数学上可以证明,略了)。
也就是说,如果不是P-矩阵,那么$x_0$就不是单调下降的,这样基变换可能变回已经变过的基,从而造成无限循环。此时可通过使用Bland规则防止。
也就是说,Lemke算法走的是一条直线:
$$ x_0进基 \rightarrow x_0替换第i_1个互补对 \rightarrow x_0 替换第i_2个互补对 \rightarrow \cdots \rightarrow x_0替换第i_n个互补对 \rightarrow x_0出基 $$这样子一看,Lemke算法好像也是在做枚举,只是枚举的是替换的哪个互补对。
确实。最坏情况下要将所有的互补对都替换完,复杂度和枚举同阶都是$2^n$。但Lemke的优点在于:
- 每步代价更少。枚举法每步都要重解方程组$O(n^3)$,而Lemke是增量更新$O(n^2)$。
虽然总体来说还是没那么快,但Lemke算法胜在总能找到精确解(如果存在的话)。这也是为什么图形学和游戏物理引擎中喜欢用Baraff方法或PGS的原因,他们很快,虽然并不精确。
从P-矩阵看算法的结果#
先规范化一下之前说的枚举法:
定义所有下标的整数索引集合:
$$ \mathcal{I} = \{1, \cdots, n\} $$然后定义所有$x$和$y$大于0的下标所组成的集合:
$$ \begin{aligned} \mathcal{F} &= \{i : y_i \ge 0 \} \\ \mathcal{A} &= \{i : x_i \ge 0 \} \end{aligned} $$然后将LCP条件$y = Ax + b$变成矩阵形式:
$$ \begin{bmatrix} I & -A \end{bmatrix} \begin{bmatrix} y \\ x \\ \end{bmatrix} = b $$思路是找到一种方法,这个方法给出的$y_i, x_i$为LCP的解,即:
$$ \begin{bmatrix} I_{*\mathcal{F}} & -A_{*\mathcal{A}} \end{bmatrix} \begin{bmatrix} y_{\mathcal{F}} \\ x_{\mathcal{A}} \\ \end{bmatrix} = b $$其中$I_{*\mathcal{F}}$是$I$的子矩阵,他的列由$\mathcal{F}$中的下标给出。比如$\mathcal{F} = \{1, 2, 5\}$,那么$I_{*\mathcal{F}}$就是由$I$中第1,2,5列组成的子矩阵。$A_{*\mathcal{A}}$同理。而$y_{\mathcal{F}}$就是$\mathcal{F}$下标指定的$y$中元素组成的列向量。
其实这种定义是枚举法的反向思路:枚举法是确定所有$x_i, y_i$为0的变量,来解出剩下变量。而这里是确定所有$x_i, y_i > 0$,他们合法地构成解,那么剩下的变量就自然都是0。
给两个矩阵名称:
$$ \begin{aligned} C &= \begin{bmatrix} I_{*\mathcal{F}} & -A_{*\mathcal{A}} \end{bmatrix} \\ s &= \begin{bmatrix} y_{\mathcal{F}} \\ x_{\mathcal{A}} \\ \end{bmatrix} \end{aligned} $$这样,原LCP问题就变成验证这个LP问题是否有解:
$$ \begin{aligned} & & Cs = b \\ & \text{subject to} & s \ge 0 \end{aligned} $$一般地,$C$叫做互补矩阵。而$C$中所有列张成的锥叫做互补锥(这里的锥就是指凸优化中的锥)。
这里可能有疑问:为什么$C$中列张成的是锥而不是其他形状?如果将s看成是系数,那么$C$展开后就是矩阵$\begin{bmatrix}I_{*\mathcal{F}} & -A_{*\mathcal{A}} \end{bmatrix}$的非负组合,显然就是锥的定义。
那么这个LP解存在性问题就变成检验$b$是否在$C$的正锥中,即:
$$ b \in \{Cs : s \ge 0\} $$这里可以通过一个例子来可视化一下,取:
$$ \begin{aligned} A &= \begin{bmatrix} 2 & 1\\ 1 & 3\\ \end{bmatrix} \\ b &= \begin{bmatrix} -4 \\ -9 \end{bmatrix} \\ \end{aligned} $$然后看一下所有$\mathcal{A}$的可能取值:
| $\mathcal{A}$ | $C(\mathcal{A})$ 的生成元 | 是否含 b |
|---|---|---|
| $\varnothing$ | $e_1,\ e_2$(第一象限) | 否 |
| $\{1\}$ | $-A_{\cdot1}=(-2,-1),\ e_2$ | 否 |
| $\{2\}$ | $e_1,\ -A_{\cdot2}=(-1,-3)$ | 否 |
| $\{1,2\}$ | $-A_{\cdot1},\ -A_{\cdot2}$ | 是 |
| 这些情况下构成的锥如下: |
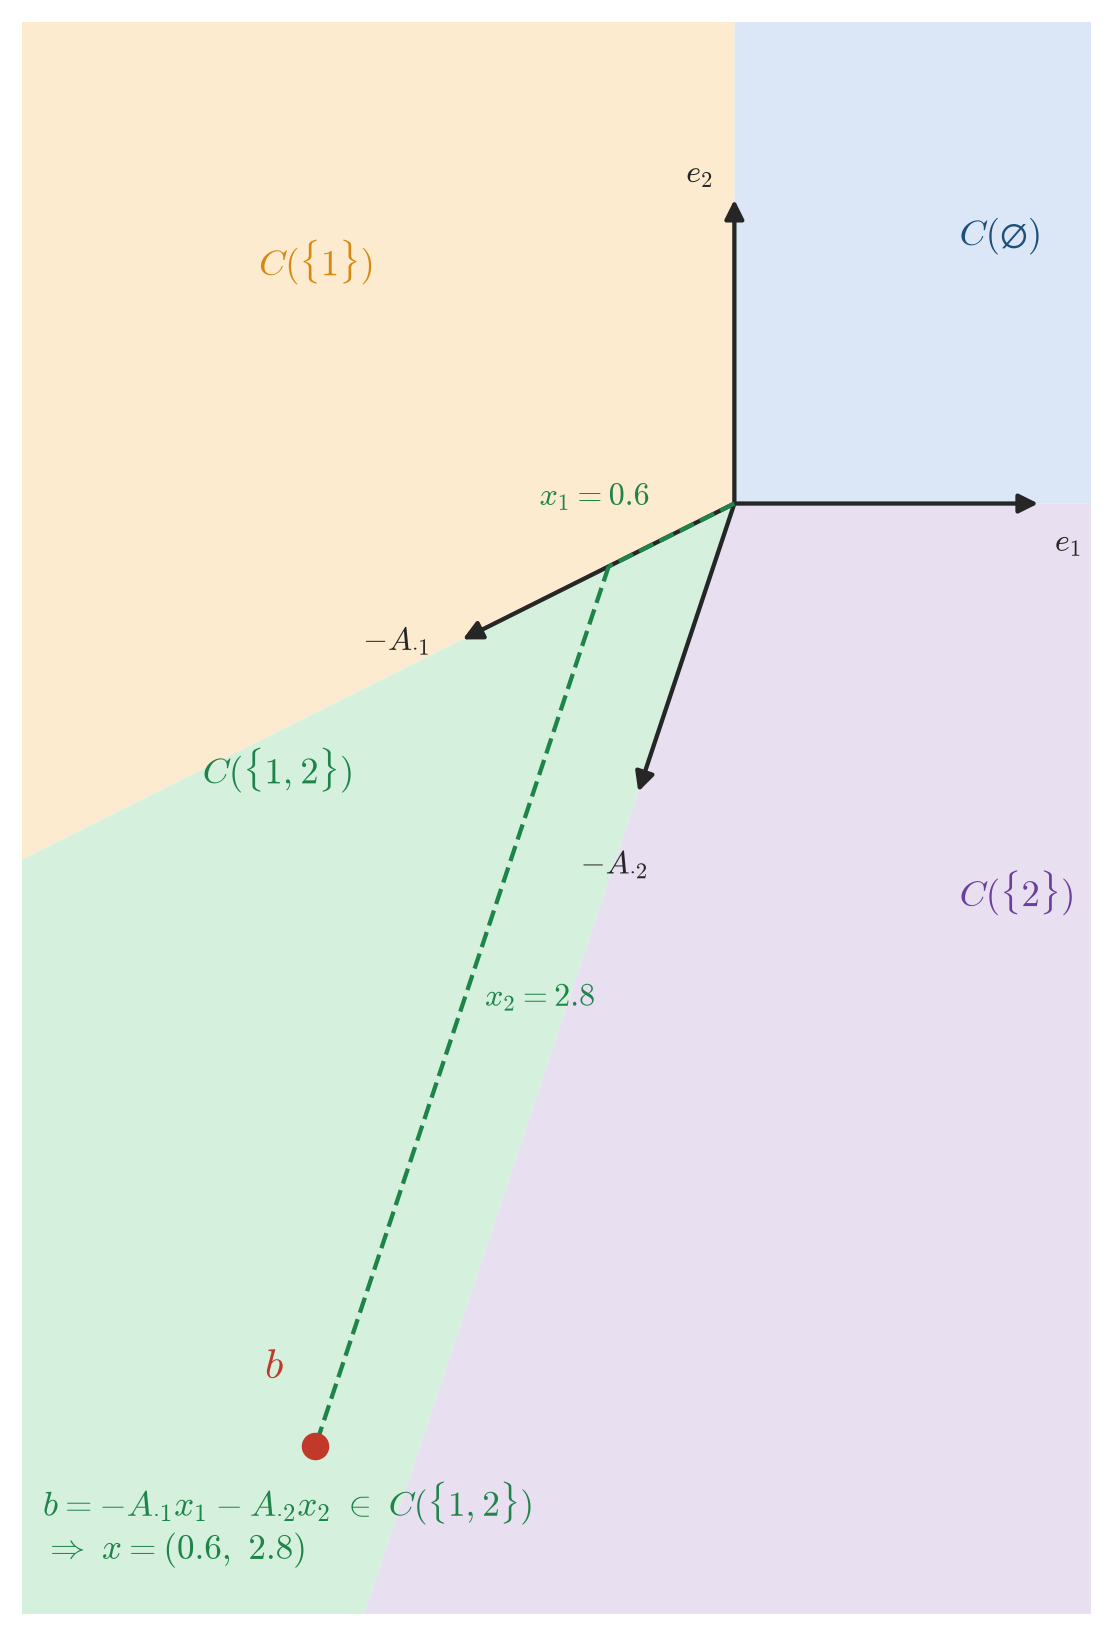
而$b$一定得落在某个正锥中,因为$b$是$Cs$为$C$的非负组合的其中一种组合(在确定了$s$时)。
注:“互补锥”中的互补和“互补松弛”中的互补是一个意思,是指从$\mathcal{A}$和$\mathcal{F}$中挑一对出来。
如果$A$是P-矩阵,那么每个锥之间两两不相交,且并集时整个$R^n$(正如上图中所示)。 如果$A$不是P-矩阵,那么锥之间可能重叠(如果$b$在重叠处就有多个解),也可能有缝(如果$b$在缝内就无解)。
P-矩阵是指:
所有主子式都为正的矩阵
Dantzig-Cottle方法#
Dantzig-Cottle方法也是一种主元法,也就是说他整个算法框架也是主元法的框架(入基出基,主元变换,比值检验)。
Dantzig法不引入额外变量,他直接在互补基之间换基。
Dantzig法通过不停地将为负的基变量提升至非负,来寻求解。
Dantzig法有两种:
- 当$A$是对称矩阵或P-矩阵时,可以使用简单的Dantzig方法
- 否则,使用完整的Dantzig-Cottle方法
接下来看一下简单的Dantzig-Cottle方法。
简单Dantzig算法步骤#
对于$y = Ax + b$,首先一样,将所有$x$视为非基变量,这样$y = b$。
此时,如果$b > 0$,那么就已经找到解了,算法结束。
否则,找到$b$中最负的那个分量对应的下标$i$:
$$ i = \arg_i \min{b_i} $$这样,驱动变量就是$y_i$的互补变量$x_i$。而$y_i$本身是区分变量(distinguished variable)。
然后对第$i$对互补变量做主元变换,也就是将$x_i$视为基变量,$y_i$视为非基变量,然后对他两做主元变换。
然后再找到更新后的$b$中最负的那个分量对应的下标,继续做主元变换。
当所有基变量对应的$b_i$都非负时,就得到LCP的解,算法结束。
完整Dantzig-Cottle算法步骤#
和简单版差不多,只是在找驱动变量时不太一样。
第一次主元法前和简单版一样,找$b$中最负的那个分量对应的基变量。然后直接对其和其互补变量做主元变换。
但是之后需要找到新的最负变量后,要对所有基变量进行比值检验,找到比值最小的那个变量(称为阻塞变量(blocking variable)),这时:
- 如果区分变量和阻塞变量是同一个变量,算法终止。此时
- 如果所有基变量非负,算法找到解
- 否则,继续下面的操作
- 否则,对阻塞变量和其互补变量做主元变换
算法一直跑,直到达到不可行条件:当选出的区分变量$y_i$对应的$b_i < 0$,且$\bar{A}_{ii} = 0$,并且对所有基变量(下标用$r$表示),$\bar{A}_{ir} > 0$,那么此时无解。
这里$\bar{A}$是指已经被前几部的高斯消元法修改过的$A$矩阵。
为何成立#
Dantzig算法的核心思想是:不断地改变互补基,直到解出的所有基变量都是非负的。这样就找到解了。
他和Lemke不同,他根本不构造新问题,而是直接在原问题上求解。
简单来说,对于互补变量们:
$$ \begin{aligned} \begin{bmatrix} y_1 \\ y_2 \\ \vdots \\ y_n \\ \end{bmatrix} \begin{bmatrix} x_1 \\ x_2 \\ \vdots \\ x_n \end{bmatrix} \end{aligned} $$由于其变量必须要“交错地”为0,即从$i = 1$到$i = n$中,必须有$x_i$或$y_i$其中一个为0。而Dantzig方法就是让0在每一对互补变量中切换(交换某对互补变量的基和非基):
$$ \begin{aligned} \begin{bmatrix} y_1 \\ 0 \\ \vdots \\ y_n \\ \end{bmatrix} \begin{bmatrix} 0 \\ x_2 \\ \vdots \\ 0 \end{bmatrix} \xRightarrow{\text{某一步,交换互补基,假设是 } i = 2} \begin{bmatrix} y_1 \\ y_2 \\ \vdots \\ y_n \\ \end{bmatrix} \begin{bmatrix} 0 \\ 0 \\ \vdots \\ 0 \end{bmatrix} \end{aligned} $$他就是通过这样不停地试来找到最后的解。
当然,试的过程中不是枚举法。通过比值检验可以找到最有可能构成解的互补基然后交换。
而算法终止条件中,$\bar{A}_{rr} = 0$说明让驱动变量$x_r$增大时(做高斯消元法时),其互补变量$y_r$不会跟着增加,那么$y_r$就一直是负的,这样无论怎么做都无法进行下一步了,原问题肯定是无解的。
PGS(Project Gaussian Seidel)#
投影高斯-赛德尔算法。是高斯-赛德尔算法的扩展版。
其算法非常简单粗暴:本身使用高斯-赛德尔算法解$y = Ax + b$这个方程组,只是每次得到解后都强制将解置为非负(即如果解为负,则强制为0)。这样不停迭代最后得到结果。
只有在矩阵$A$正定时,PGS才在松弛因子(如果是SOR版本的话)$0 < \omega < 2$中收敛。否则无法证明其敛散性。
PGS广泛被用于游戏物理引擎中。但是其本质上还是个近似算法。在接触问题的$M = JM^{-1}J^{-1}$中,$M$甚至是半正定矩阵,或者有时候是奇异矩阵,这导致PGS根本不能保证其收敛性。但耐不住人家算起来是真的快,而且解出来的通常是物理上可接受的。
不收敛的PGS可能会返回一个可行但非互补的错误点,这时需要一些工程上的其他手段去修正。
这里顺便说一下PGS的形式。我们可以从最原始的Jacob迭代法说起(因为有些资料里面还是提到了Jacob算法所以还是从头说一下)(这些本来是《数值分析》中的知识,不属于LCP,这部分内容参考Sauer的数值分析1)。
Jacob迭代法是一种解线性方程组的不动点迭代法。
所谓不动点迭代法(FPI - Fixed Point Iteration),是指找到一个不动点,而不动点有很多优良性质,可以在数学上证明此迭代法在某些条件下是收敛的。
对于任意函数$f(x)$,通过改写他为如下形式的等式:
$$ x = g(x) $$此时$x$就叫不动点。即将自己代入方程,得到的解是自己。而原方程$f(x)$的根就是此不动点。
比如对函数$x^3 + x - 1 = 0$,就可以改造成$x = g(x) = 1 - x^3$。满足$x = g(x)$的$x$就是原方程的根。
而不动点迭代法就是:
- 给出初始猜测$x_0$
- 每次使用不动点法得到新$x_{k+1} = g(x_k)$
如此循环,在$k \rightarrow +\infty$时算法可能可以收敛到$f(x)$的根(具体能不能收敛得看$g(x)$性质)。
而收敛的条件是(任选其一):
- 满足压缩映射定理(充分条件),此定理可以证明在一个闭区间$[a, b]$上存在唯一不动点,而且对任意$x_0 \in [a, b]$的初始猜测,算法都能收敛到不动点。
- 满足局部收敛准则,在已知某领域内的唯一不动点时,在其附近做不动点迭代法可以收敛到此不动点。
这两条定理内容可以参阅任意数值分析书籍,不再赘述。
而雅克比算法给出的不动点形式是:
对于方程组$y = Ax + b$:
$$ x_{k+1} = D^{-1}(b - (L + U)x_k) $$其中$D$是$A$的对角矩阵,$L, U$是他的严格下/上三角矩阵。
而收敛条件则是(任选其一):
- 严格对角占优(充分条件):对每一行,主对角元素的绝对值严格大于该行所有其他元素绝对值之和,即$|A_{ii}| \gt \sum_{j \ne i} |A_{ij}|$
- 弱对角占优+不可约(充分条件)
- 弱对角占优,是指严格对角占优中允许等于的情况:$|a_{ii}| \ge \sum_{j \ne i} |a_{ij}|$
- 不可约:存在置换矩阵$P$,使得$PAP^T = \begin{bmatrix}A_{11} & A_{12} \\ 0 & A_{22}\end{bmatrix}$。其中$A_{11}, A_{22}$都是非空方阵,则$A$可约,否则不可约
注:和高斯-赛德尔算法的区别是,对称正定矩阵并不能保证收敛。
而高斯-赛德尔算法是Jacob算法的改良版,其不动点是:
$$ x_{k+1} = D^{-1}(b - Ux_k - Lx_{k+1}) $$他看上去是隐式的方法(即等式两边都含有$x_{k+1}$),但其实可以显式地解:
Jacob算法每次迭代都只使用上一轮的旧值。你如果把高斯-赛德尔迭代式里面的矩阵拆开,可以发现而它是只要算出新值,就立刻使用新值。
举个例子,以
$$ \begin{bmatrix} 3 & 1 & -1 \\ 2 & 4 & 1 \\ -1 & 2 & 5 \end{bmatrix} \begin{bmatrix} u \\ v \\ w \end{bmatrix} = \begin{bmatrix} 4 \\ 1 \\ 1 \end{bmatrix} $$为例,其$D, U, L$分别是:
$$ \begin{aligned} D &= \begin{bmatrix} 3 & 0 & 0\\ 0 & 4 & 0 \\ 0 & 0 & 5 \end{bmatrix} \\ U &= \begin{bmatrix} 0 & 1 & -1 \\ 0 & 0 & 1 \\ 0 & 0 & 0 \end{bmatrix} \\ L &= \begin{bmatrix} 0 & 0 & 0 \\ 2 & 0 & 0 \\ -1 & 2 & 0 \end{bmatrix} \end{aligned} $$那么$u, v, w$的更新公式就是:
$$ \begin{aligned} u_{k+1} &= \frac{4 - v_{k} + w_k}{3} \\ v_{k+1} &= \frac{1 - 2u_{k+1} - w_k}{4} \\ w_{k+1} &= \frac{1 + u_{k+1} - 2v_{k+1}}{5} \\ \end{aligned} $$他相比Jacob算法的优点就是$A$是对称正定矩阵时他也收敛,而且他在某些条件下(比如对称阵)比Jacob快近一倍。并且内存减半(不需要存老的$x_k$)
最后是PGS算法,就是在每次算出$x_{k+1}$后将其Clamp在$[0, +\infty]$中(注意Clamp 必须立即生效,投影后的值要马上被后续分量使用。如果先把所有分量算完、最后统一投影,那是 Projected Jacobi,不是 PGS)。
最后简单说一下超松弛算法(SOR - Successive Over-Relaxation):
即加上一个超松弛参数$\omega$,将原式变为:
$$ \begin{aligned} x_{k+1} &= (1-ω) x_k + ω D^{-1}( b - L x_{k+1} - U x_k) \\ &\Rightarrow \\ x_{k+1} &= (\omega L + D)^{-1}[(1-\omega)Dx_{k} - \omega Ux_{k}] + \omega(\omega L + D)^{-1} b \end{aligned} $$其中:
- $\omega \in (0, 1)$:为低松弛,收敛更稳定但更慢
- $\omega = 1$:就是高斯-赛德尔算法
- $\omega \in (1, 2)$:为超松弛,算法更快但更不稳定
- $\omega \ge 2$或$\omega < 0$:算法一般发散,不建议使用
注意:此时算法好像又不用新值$x_{k+1}$了。从公式上确实如此,但一般来说我们不会去求解$(\omega L + D)^{-1}$,而是将式子变成:
$$ (\omega L + D)x_{k+1} = (1-\omega)Dx_{k} - \omega Ux_{k} + \omega b $$所以还是会用到新值。这里是两条路子,主要看你要不要预计算$\omega L + D$。
参考#
- Numerical Methods for Linear Complementarity Problems in Physics-based Animation
《Numerical Analysis》 3th, Timothy Sauer ↩︎